字模提取工具说明
📎 原始文档:https://www.kdocs.cn/l/cerF6EpBYZor 字模提取工具说明
字模提取工具下载链接
在线字符编码查询
在线字符编码转换
unicode区段查找
开源ttf查看工具
font creator
txt转xml工具
↑↑↑(≧∇≦)ノ 工具下载链接&常用字符转换网站↑↑↑
(一)简介:
该工具的作用是根据ttf生成对应.PIX和.TAB文件,用于杰理ui框架的文字显示,适用于701所有版本,可裁剪,可改字体,可换字号。其中FontTool.exe会根据font.xml文件的配置进行采集,在font.xml中可以配置对应代码页使用的ttf文件以及每个代码页中需要提取字符的范围,故可以理解为.xml文件即FontTool.exe的配置,可以通过修改.xml文件来达到修改FontTool.exe提取范围的效果。工具流程图如下:
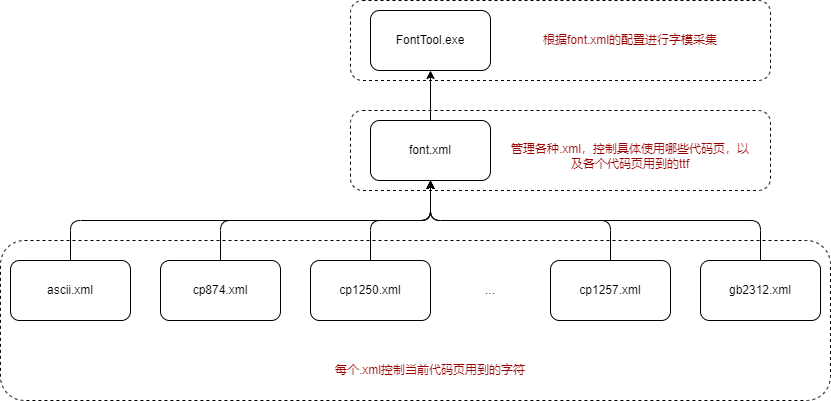 即从用户角度来看,通过修改font.xml可以裁剪出自己需要的国家的语言,而通过修改charset路径下的.xml文件可以进一步修改对应国家语言的字符范围。
需要注意的是,charset路径下的.xml文件的字符编码范围可以重复,工具会自动去重。
(二)字模提前工具目录结构:
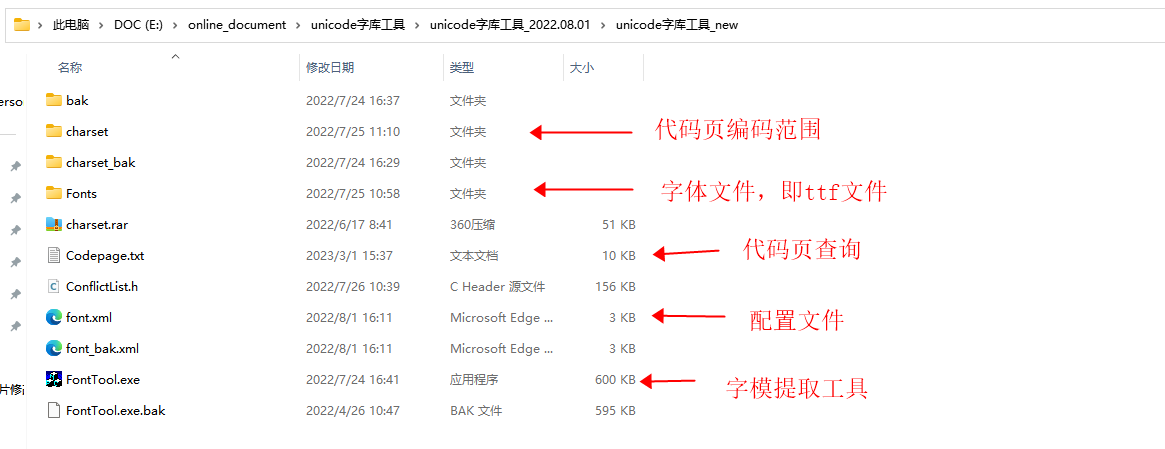 需重点留意的文件有如下几个:
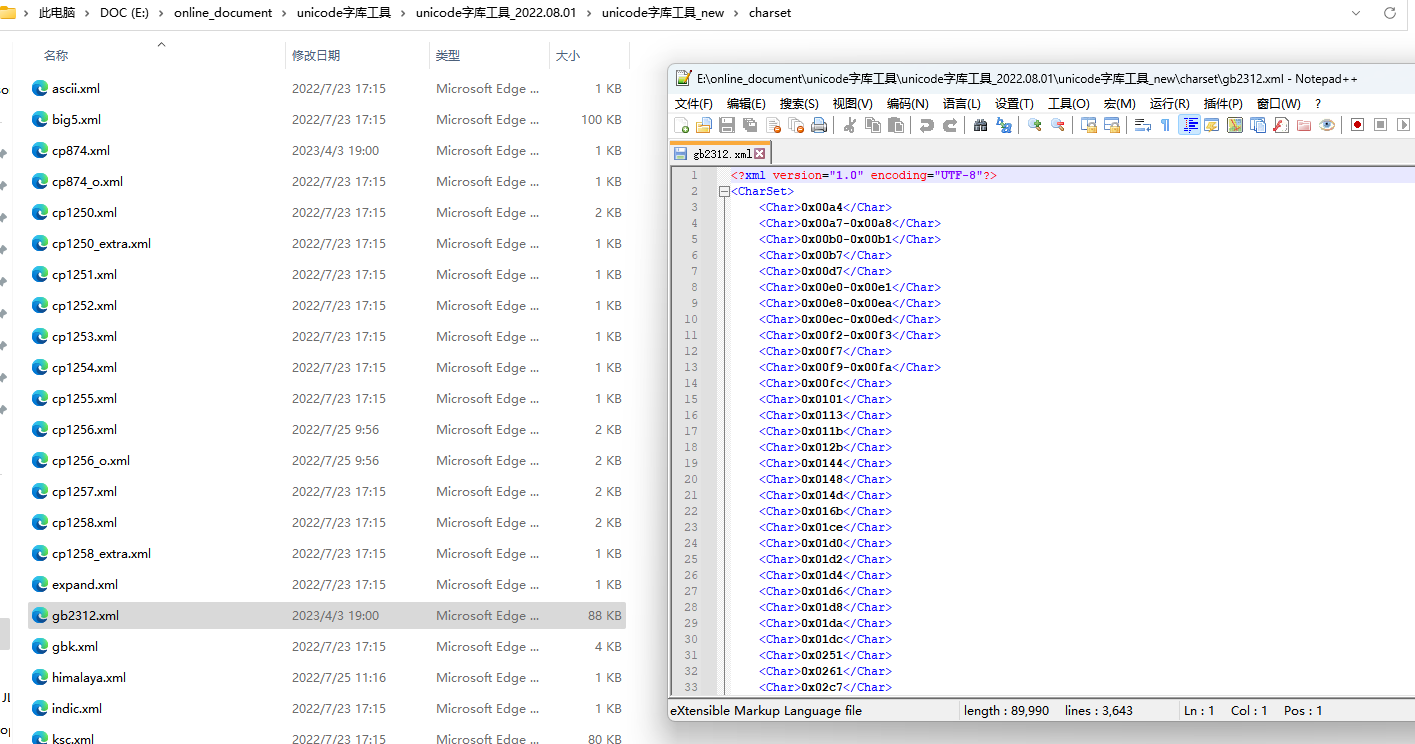
charset文件夹 存放各个代码页的.xml文件,可以修改对应.xml文件里的编码范围进行进一步的裁剪,需要注意的是里面存放的是unicode编码,只有对应的unicode编码被包含在这些xml文件里面,工具才会去采集对应字符的字模。
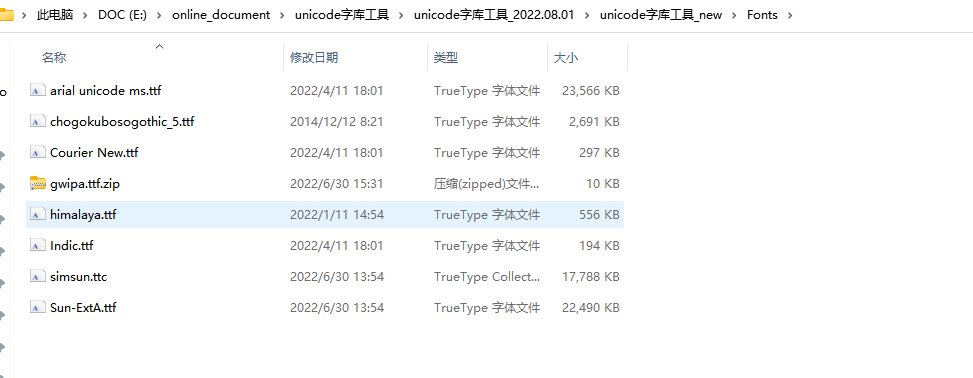
Fonts文件夹 存放常用ttf文件,可以通过更换ttf文件达到修改字体的目的,为了让目录结构不混乱,后面新增字体可以将相应ttf放到该文件夹,比如添加思源雅黑.ttf。
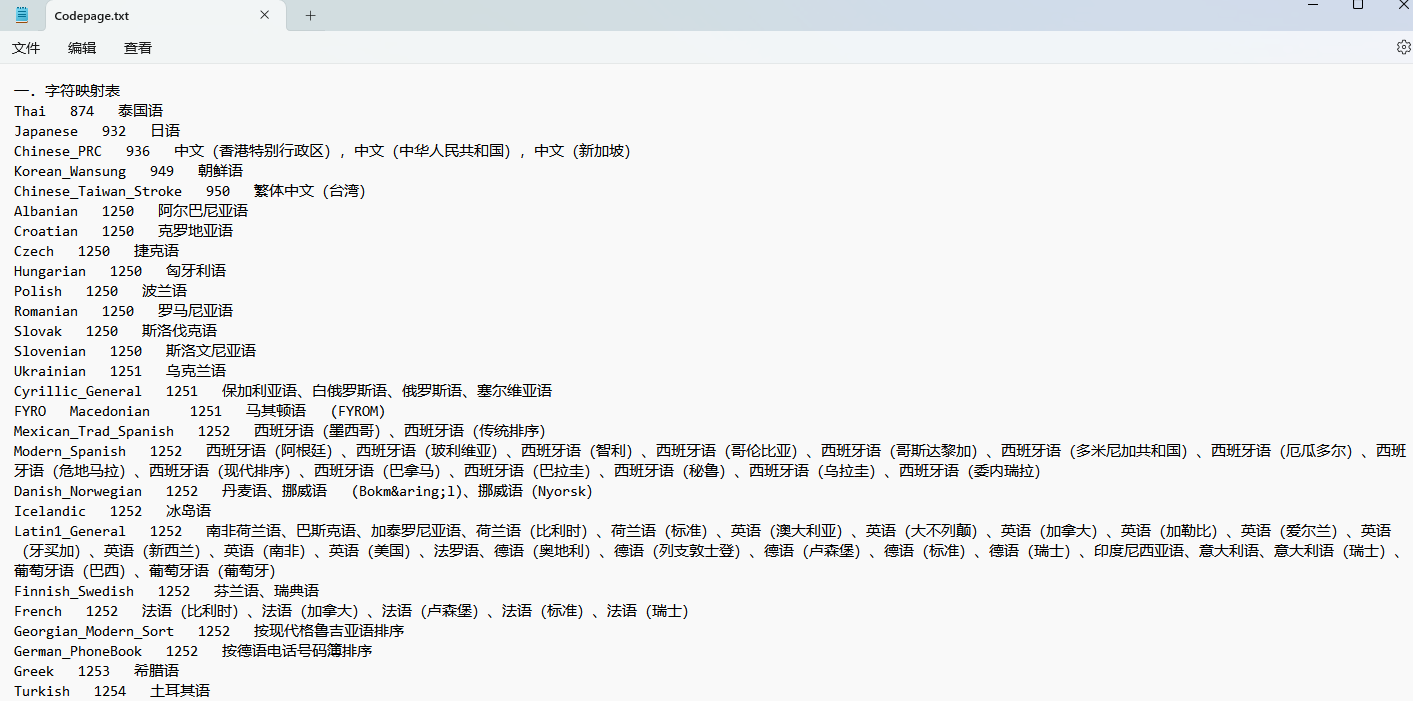
Codepage.txt文件 可以根据该文件找到对应语言的代码页,从而进行代码页裁剪。
font.xml文件 配置文件,工具会根据该文件的配置去采集对应字模,可以通过配置该文件去控制字模的采集,如代码页裁剪,以及ttf选择等。
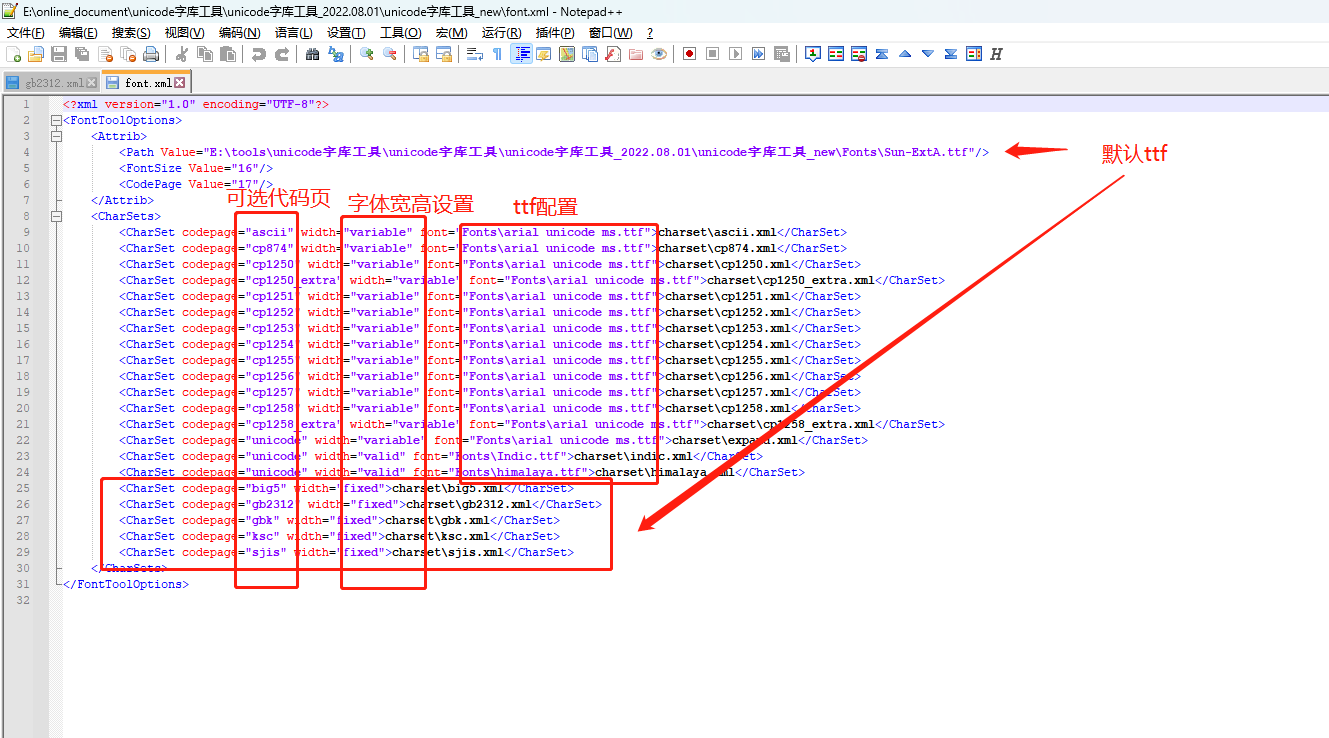 默认ttf:font.xml文件中第4行中的Sun-ExtA.ttf为默认ttf,也就是下面big5,gb2312,gbk,ksc和sjis用到的ttf;
可选代码页:可以根据上面的代码页进行删减从而实现字库裁剪;
字体宽高设置:fix为固定宽高,多用于中日韩字符;valid为截取有效部分,多用于印地语,泰语和藏语;variable为可变,对于这部分设置不建议随意修改;
ttf配置:可以给对应代码页配置特定的字体,只需要在对应代码页中更换目录下自行添加的ttf即可。
Tips:修改font.xml文件后可以重新打开一下FontTool.exe以确保配置被重新加载,防止配置被覆盖。
- FontTool.exe 字模提取工具,具体按钮功能如下:
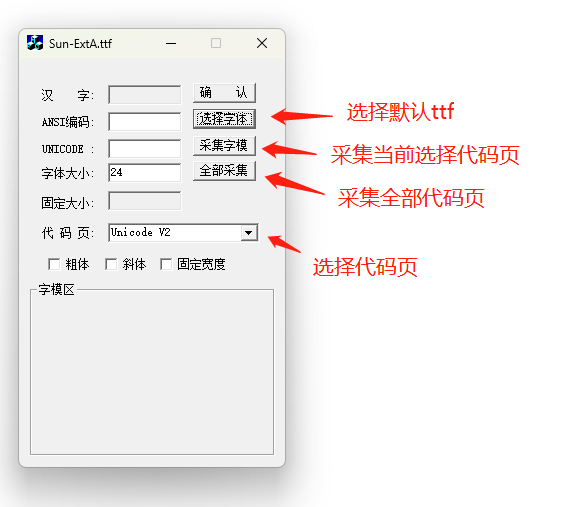 (SDK 220以前的工具)
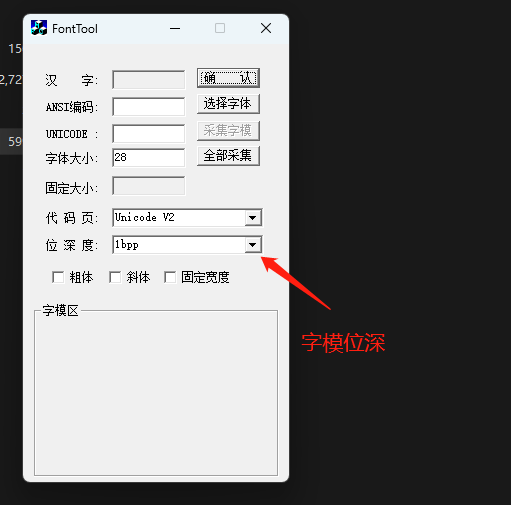 (SDK 220以后的工具)
选择字体:点击后可以在目录下选取默认的ttf,默认ttf应用于上文font.xml文件中提到的big5,gb2312,gbk,ksc和sjis这几个代码页,这意味着这里选取的ttf直接应用于简体中文、繁体中文、日语和韩语。若想要修改指定代码页的ttf,可以在Font.xml中进行修改;
采集字模:采集当前选择的代码页,如unicode V2就是采集unicode字库的.PIX文件,而ANSI采集的是F_ASCII.PIX,该文件也就是ascii.res,是数字控件,文字控件的内置字库;
全部采集:无视当前选择代码页,将所有代码页的字模提取到.PIX,.TAB文件中;
字体大小:可以设置字模字号,如上图为设置16字号;
粗体/斜体/固定宽度:可根据需求进行勾选,从而提取对应需求的字模;
位深度(SDK 220后新增):每像素所占位数,该值越高,字体抗锯齿效果越好,但占用空间也会增大;
字符预览:如下图所示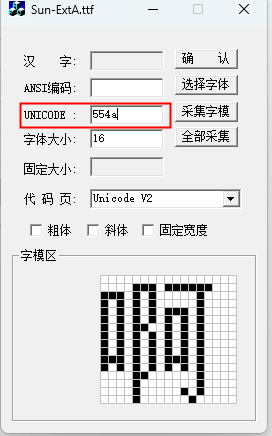 “啊”字符的unicode编码为0000554a,在红色框框中输入554a即可出现“啊”的预览。
其他_bak后缀的为备份文件。
(三)字模提取工具常用功能:
提取字模
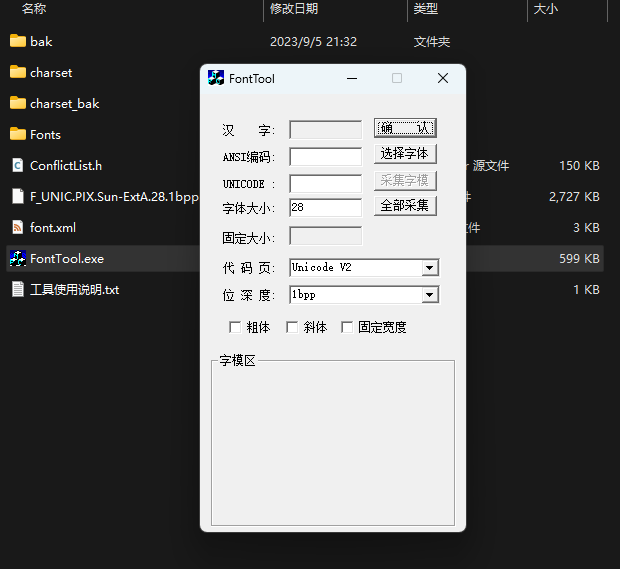 双击FontTool.exe,此时“采集字模”选项为失能状态,也就是不可点击状态,则需要点击“选择字体”,点击后会需要选择默认的ttf,若本来即处于可点击状态,则可以跳过该步骤,如下:
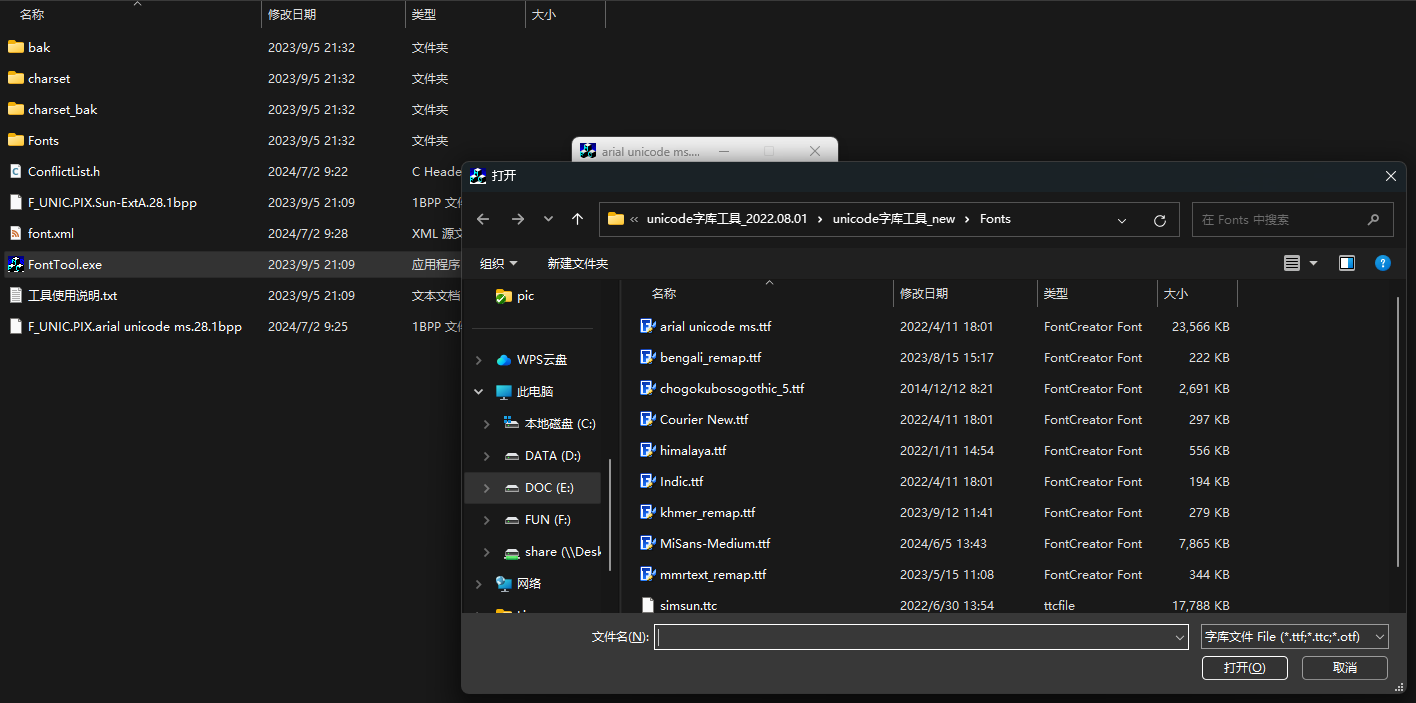 这里随机选一个,如选arial unicode ms.ttf。
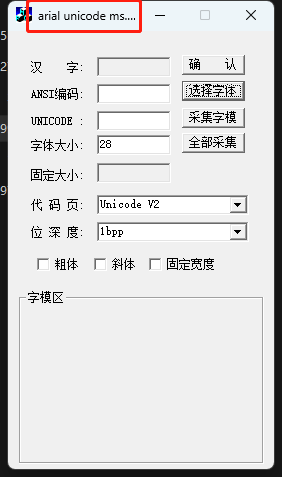 选择字体后,工具的标题变成了默认ttf的名字,同时“采集字模”选项也变为可点击状态,此时若要采集unicode字库对应的字模,“代码页”选项中选择unicode v2即可,若使用内码字库,也可自行选择1251、1252等代码页,去采集对应代码页的字模。选择代码页结束后,点击采集字模即可。
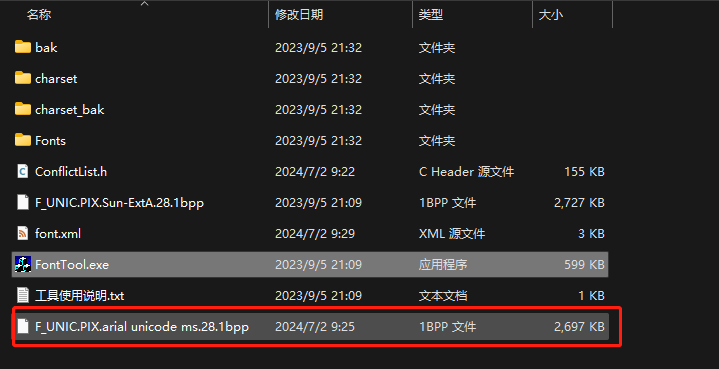 采集结束后,会有弹窗提醒已采集完成,同时同级路径下会多出一个文件,我们可以把该文件的文件名由F_UNIC.PIX.arial unicode ms.28.1bpp改为F_UNIC.PIX,去掉相关后缀,至于改的名字可由用户自行决定,但为了方便定位问题,建议使用F_UNIC.PIX或者F_UNIC_ALL.PIX的名称,在用户不是随机命名的情况下,根据以上两个名称可以直接了解到当前使用的是unicode字库。
根据语言裁剪字库并提取 需要注意的是,目前只支持unicode字库的裁剪,也就是代码页选择unicode V2时才能裁剪。这里以裁剪掉其他语言,只保留泰语,捷克语,法语和英语等拉丁语系语言,土耳其语,希伯来语,阿拉伯语,越南语,中文简体为例,进行一个简单的裁剪示范:
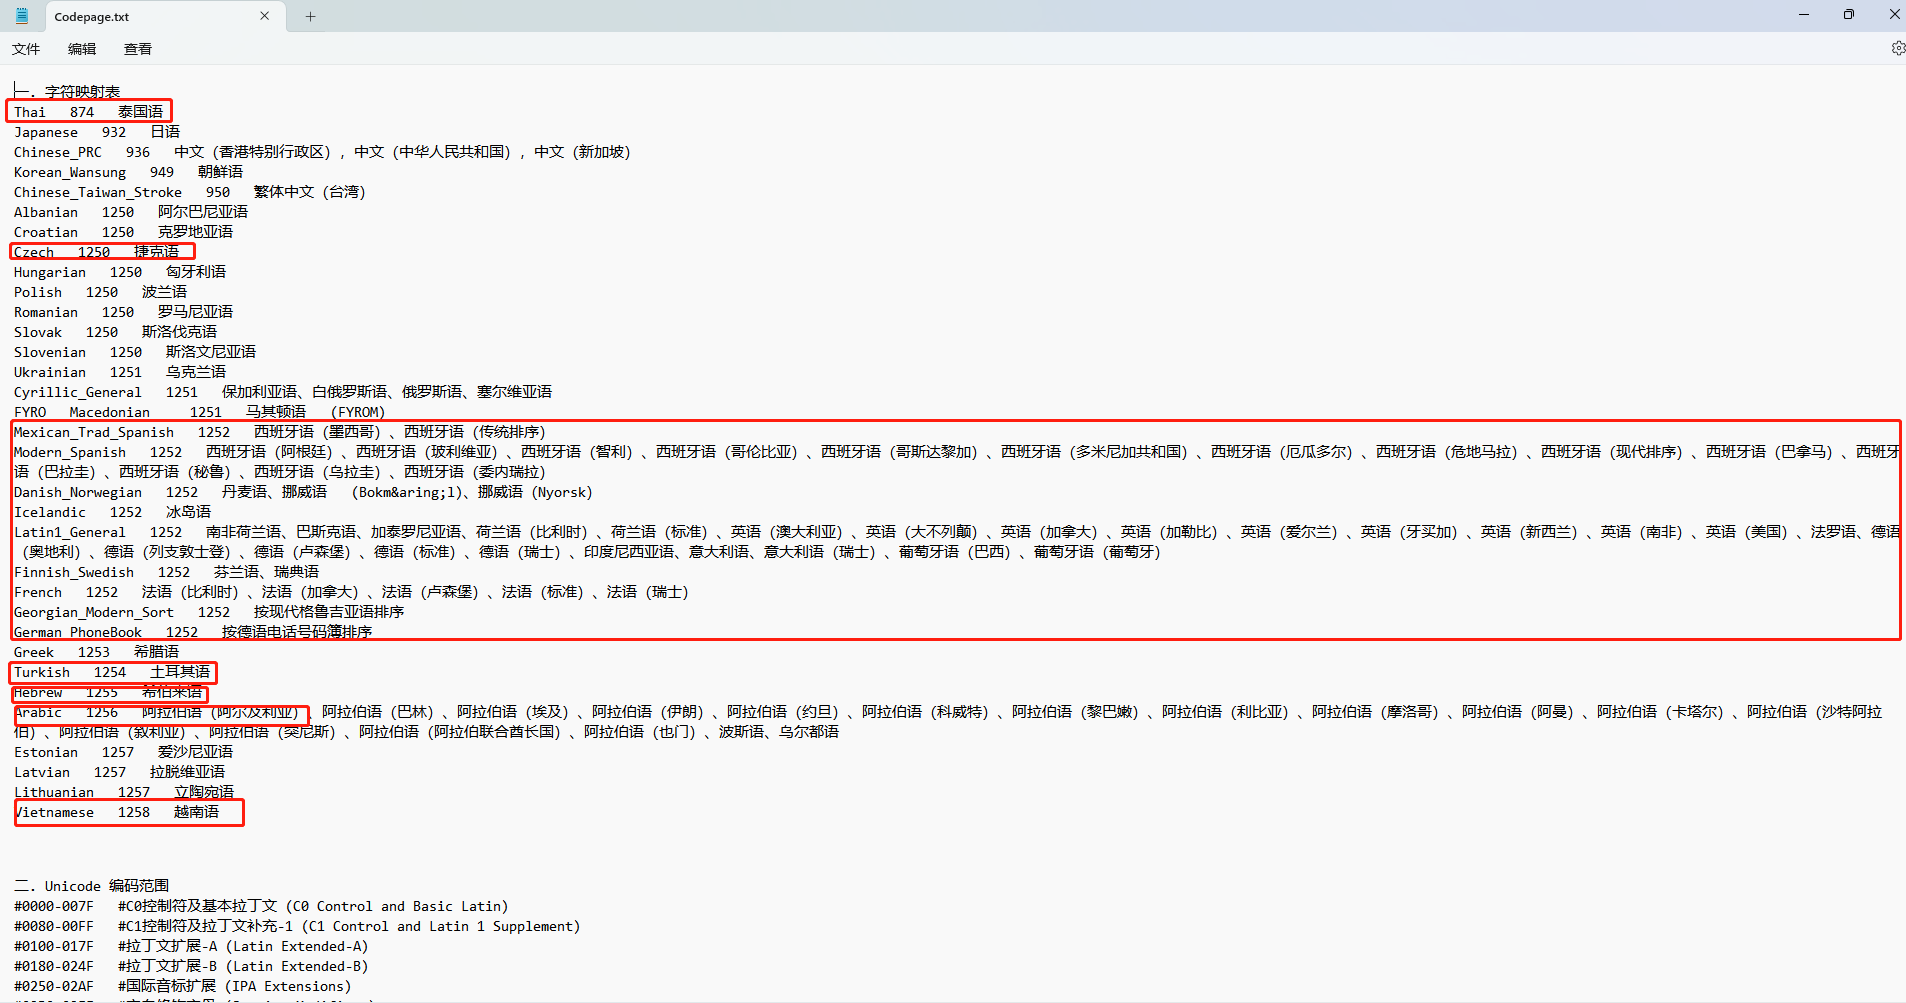 在Codepage.txt中,可以找到需要用到的代码页为acsii,2312,874,1250,1252,1254,1255,1256和1258,那么在配置文件中只保留这几项即可:
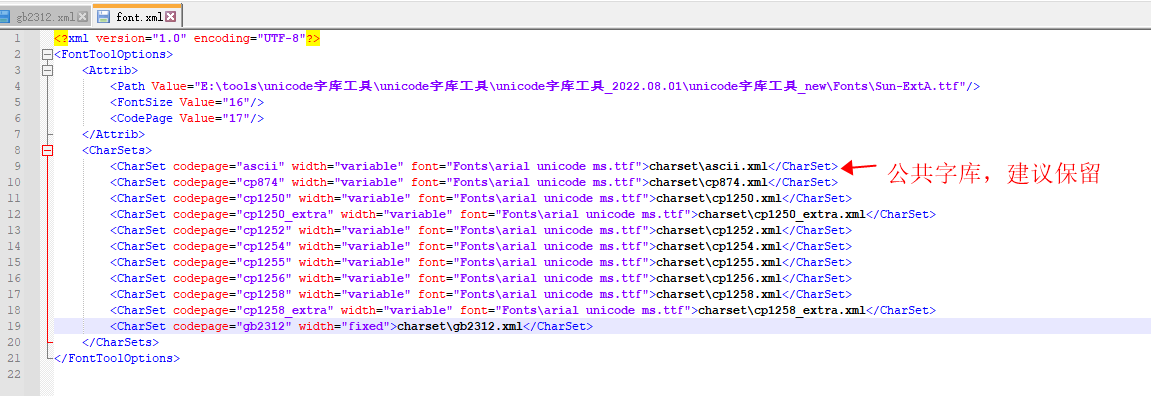 其中ascii为公共字库,包含了ascii码表的内容,建议保留。
配置结束后,打开FontTool.exe,设置相应字号,这里以字号24为例,采集unicode字库,故代码页设置unicode V2,点击“采集字模”,等待裁剪即可。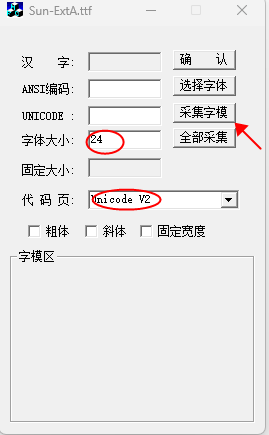
采集结束后会出现弹窗,并生成对应.PIX到当前路径下: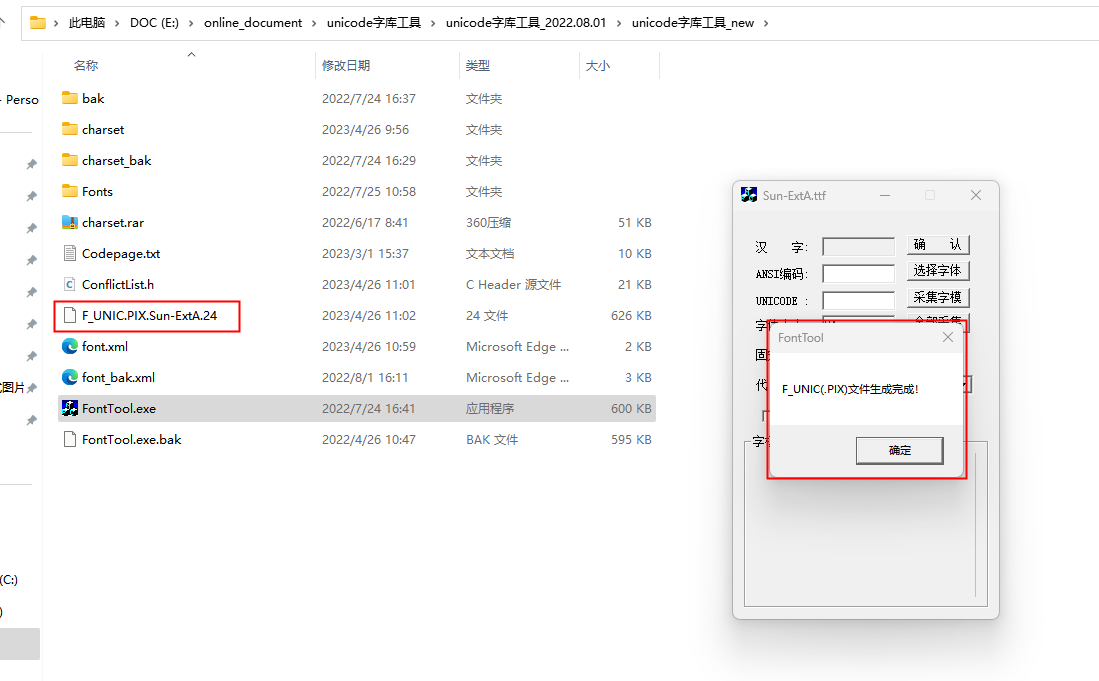 采集结束后需要修改字库文件名称,公版unicode字库的.PIX文件默认为F_UNIC_ALL.PIX,故在这里将F_UNIC.PIX.Sun-ExtA.24重命名为F_UNIC_ALL.PIX即可,之所以这样命名是为了方便判断当前使用的是什么字库,从而快速跟进问题,若有其他需求也可以修改为其他名字,在fontinit.c中匹配上即可,但需要注意名字长度有要求,不能超过15bytes,否则无法下载到flash。
至于采集其他代码页,以1252为例,选中1252 拉丁文后,点击采集字模: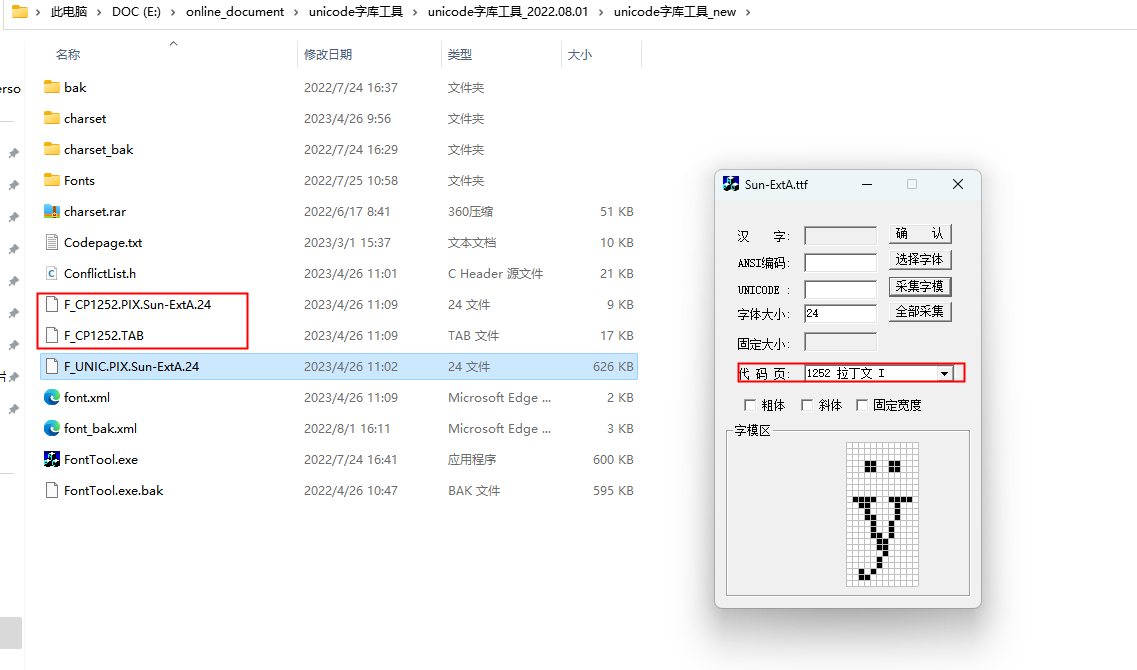 最终生成的文件,将.PIX的后缀去掉,更改为F_CP1252.PIX即可。
若需要用到生成的.PIX文件和.TAB文件,需将其放到ui_resource路径下,并在批处理添加上相应文件。
而对于在Codepage.txt中找不到的语言,可以先自行上网搜索该语言使用的字符,是否在常用的代码页里面,如果在常用代码页里面,则可以选取对应代码页去生成.PIX进行显示。
- 根据代码页编码范围裁剪字库 当前裁剪方式也是只有在选择unicode V2的情况下才能进行。若有对字库进一步压缩的需求,可以选择将一个代码页中的字符进行进一步的裁剪,目前提供两种方式:
第一种是直接根据编码范围去裁剪对应的代码页的编码,如gb2312的字符进行裁剪,仅保留常用的,可以把不需要用到的字符编码范围给去掉(查询字符编码的链接在文档顶部),比如不需要显示0x00f9~0x00fa的字符,则可以根据下图,把红色框的内容删除掉即可: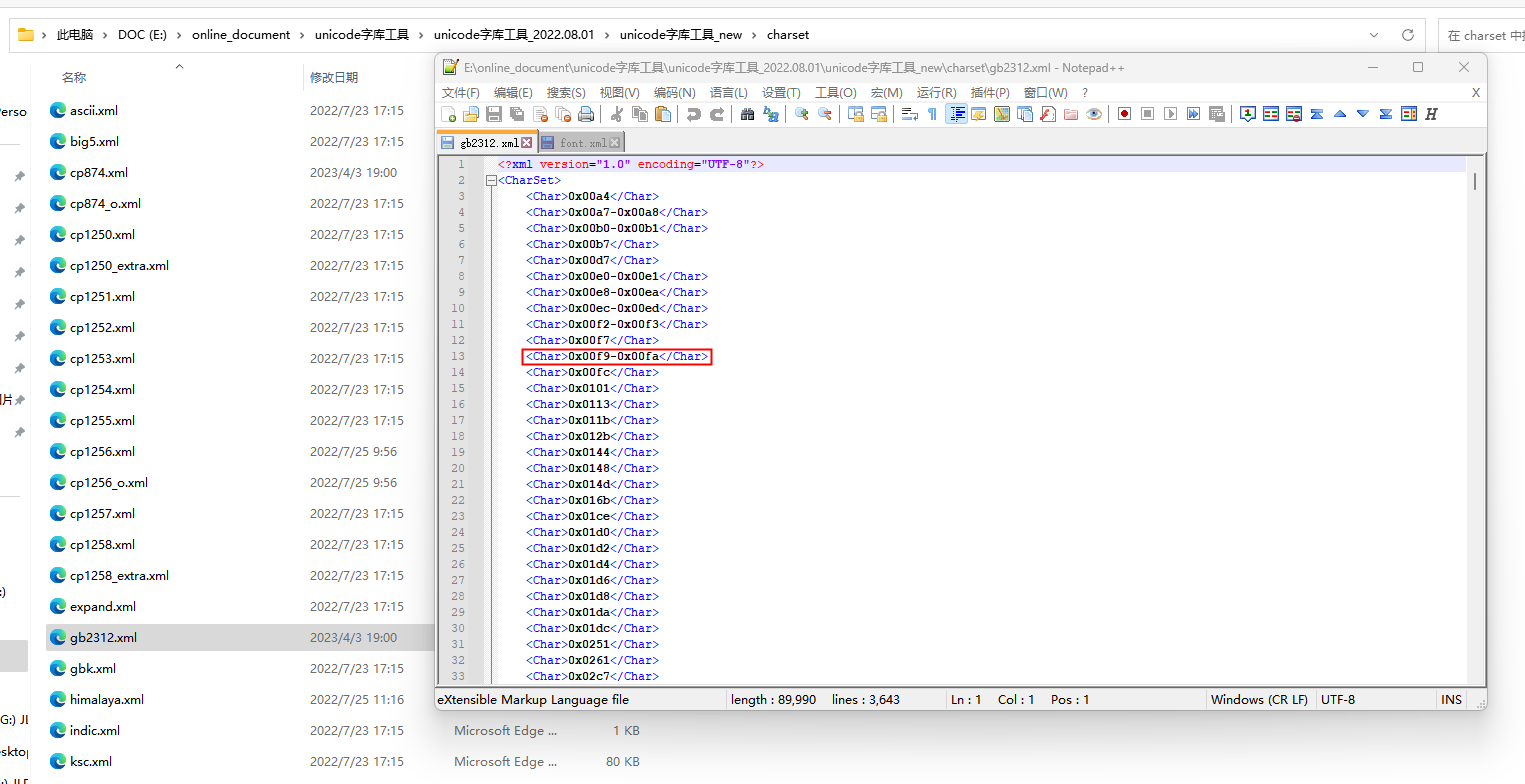 但需要注意的是,删除掉相应字符后,当输入相应字符进行显示时会显示default_code的内容,默认是“_”。
第二种是利用txt转xml工具(链接在文档顶部)进行裁剪,输入为所需的文字字符,存放在input.txt文本内,工具会将这些字符转换为合规格的xml文件进行输出。进入工具路径下会找到unicode2xml.exe文件如下图: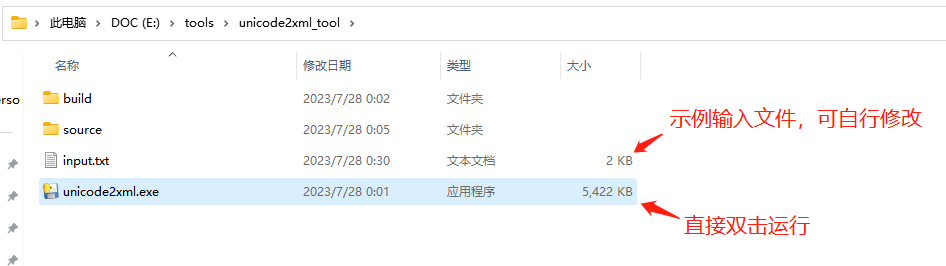
直接双击运行,即可输出output.xml文件,如下图: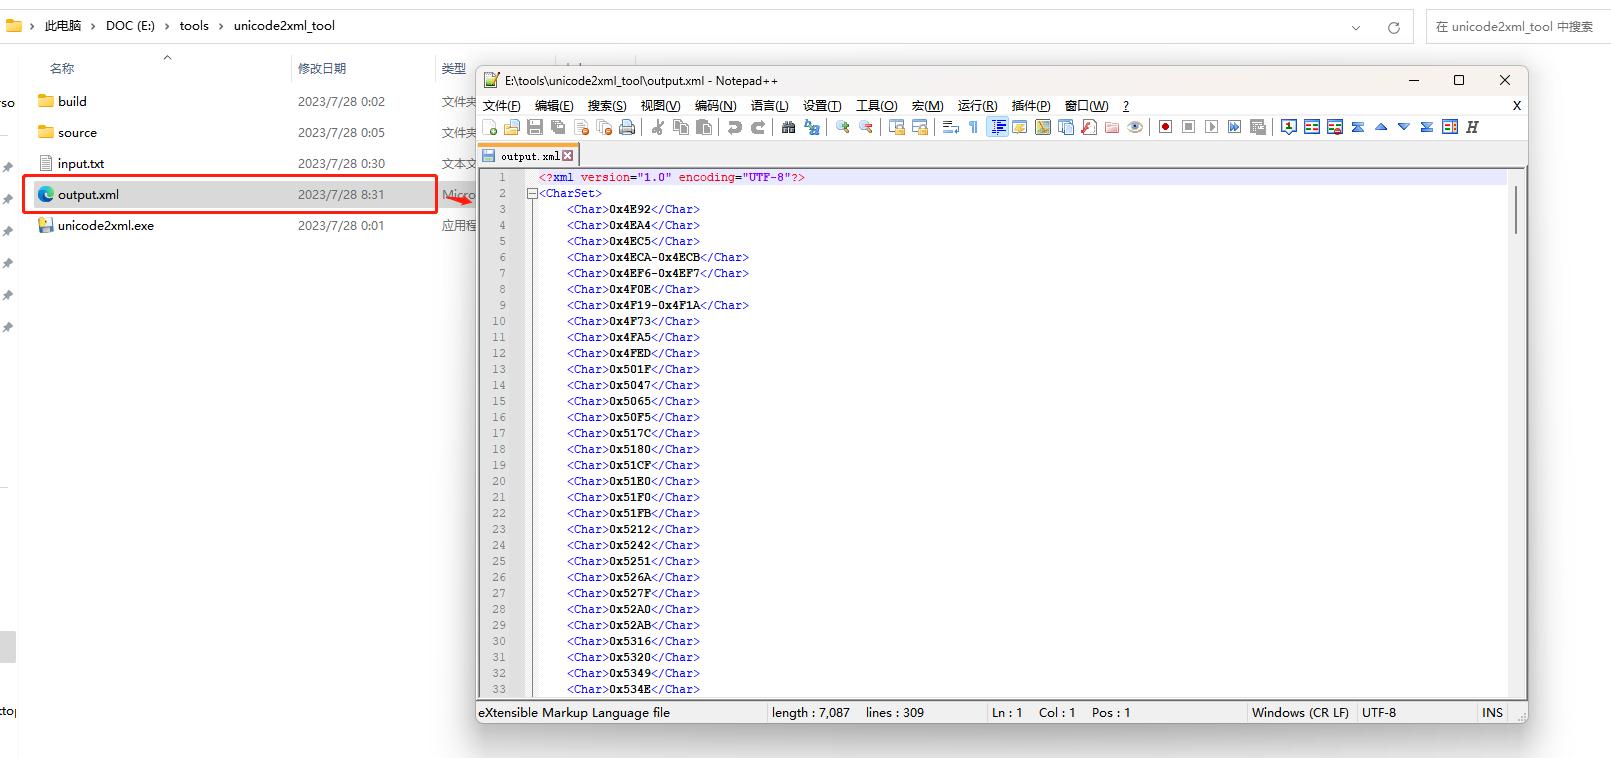 用户可自行编辑input.txt,将所需字符填充进去,再运行unicode2xml.exe即可,生成的xml文件后进行重命名,放入字模采集工具的charset文件夹后使用。
- 更换字体 这里以将1252代码页的字体换为苹方粗体为例:
将对应ttf添加到Fonts路径下: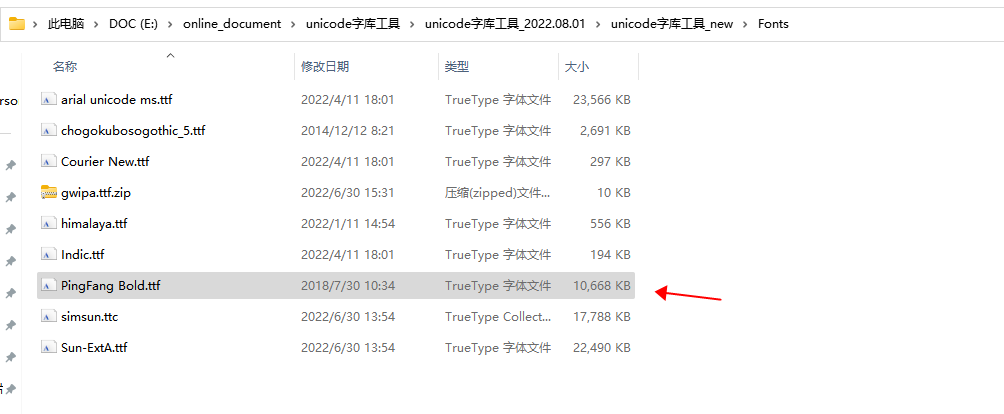 把1252代码页的ttf更换为对应ttf:
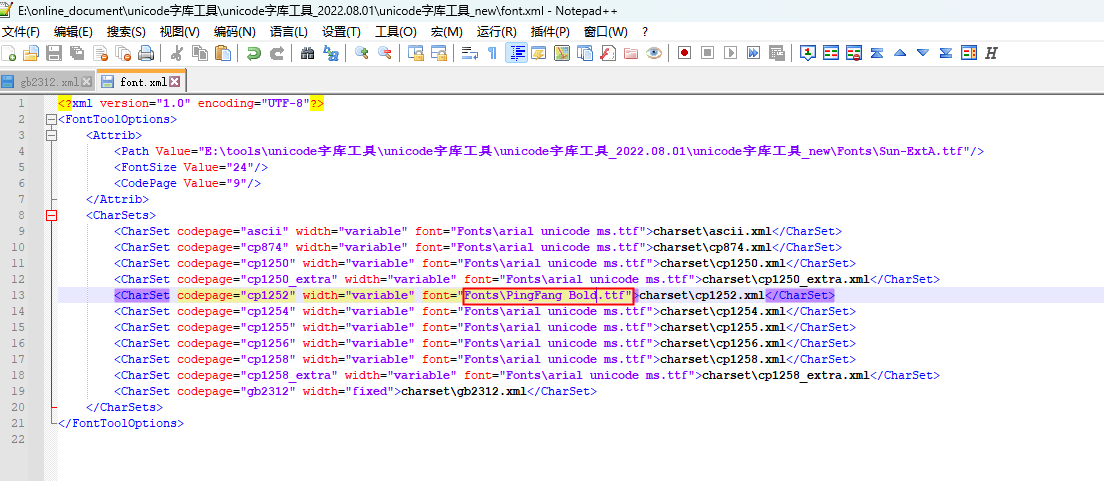 然后重新采集字模即可,其中ttf文件杰理不提供,用户需要根据自身需求自行寻找ttf进行生成。
(四)fontforge常用功能:
fontforge是一个开源免费的工具,可以帮助我们查看ttf,编辑ttf以及导出ttf,支持对单个字符进行修改,用户可以利用这个工具去生成自己所需的ttf文件,在此列出一些常用功能:
根据字符查找编码
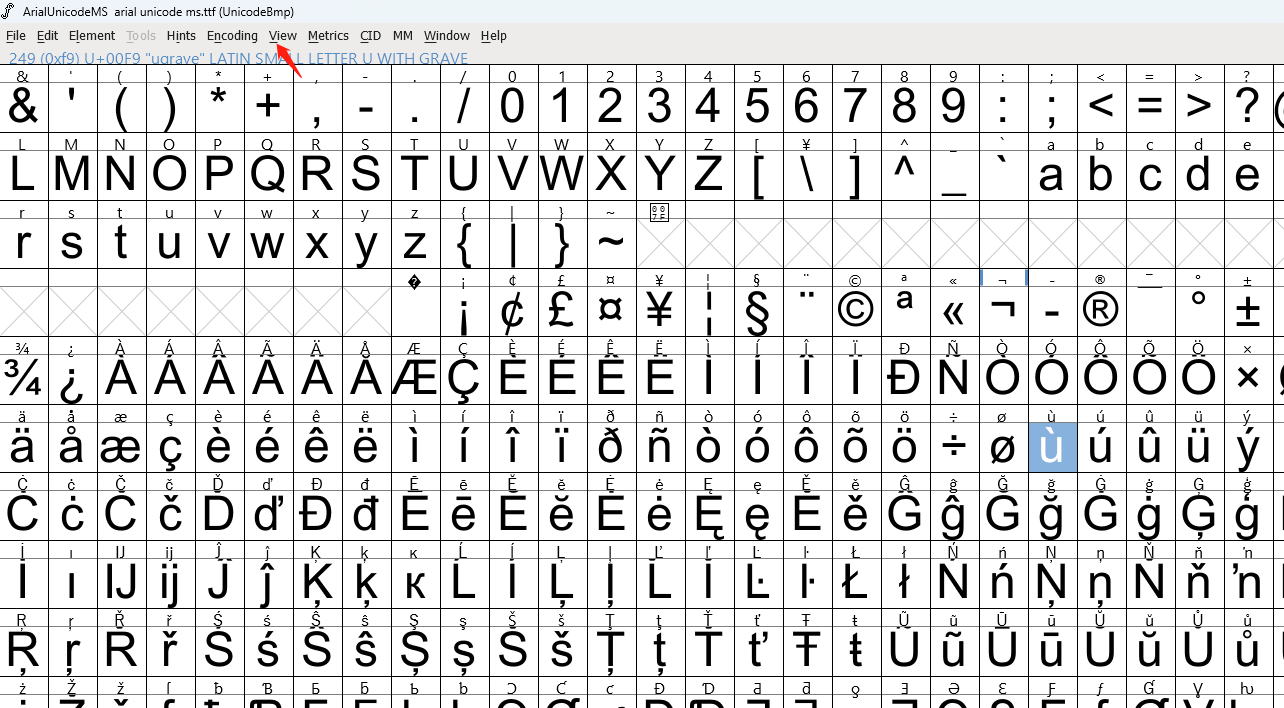
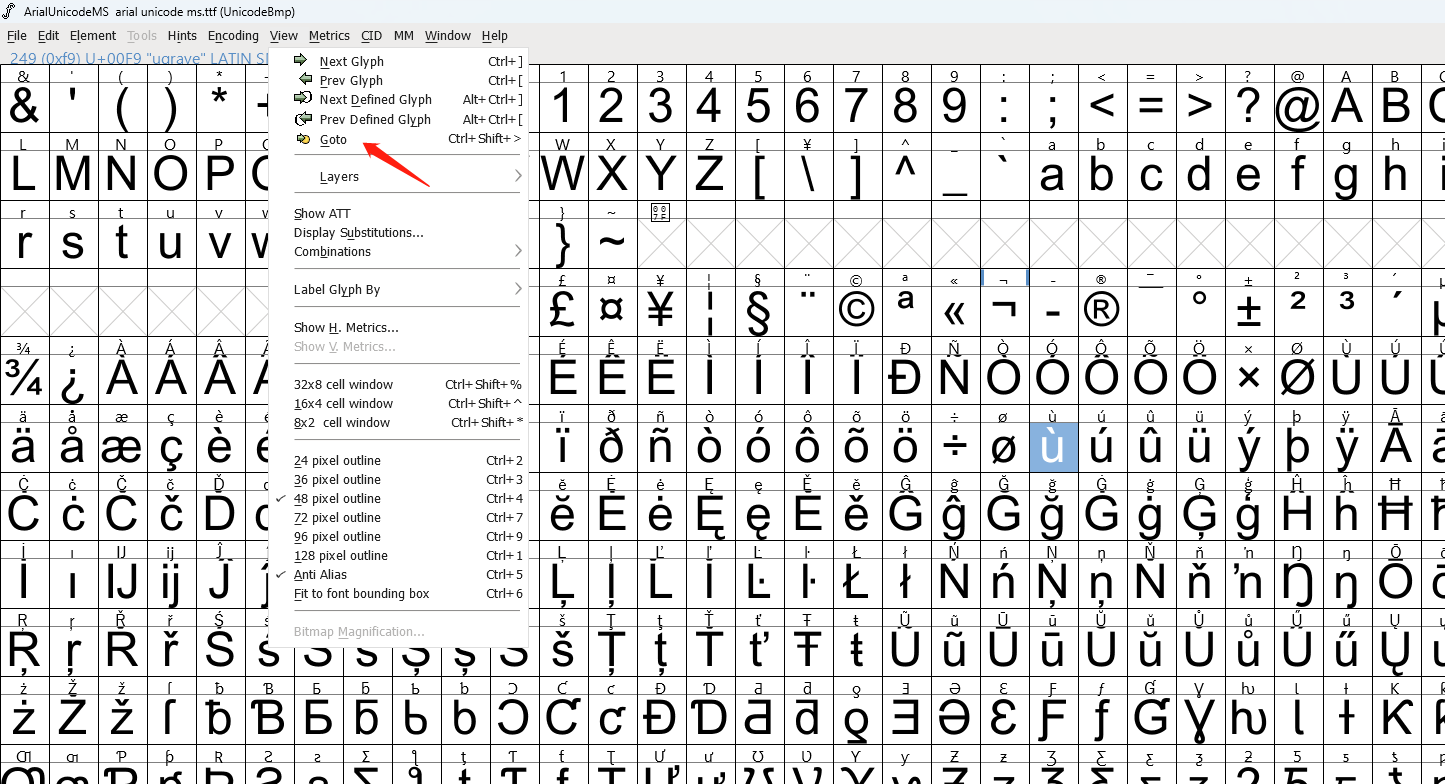
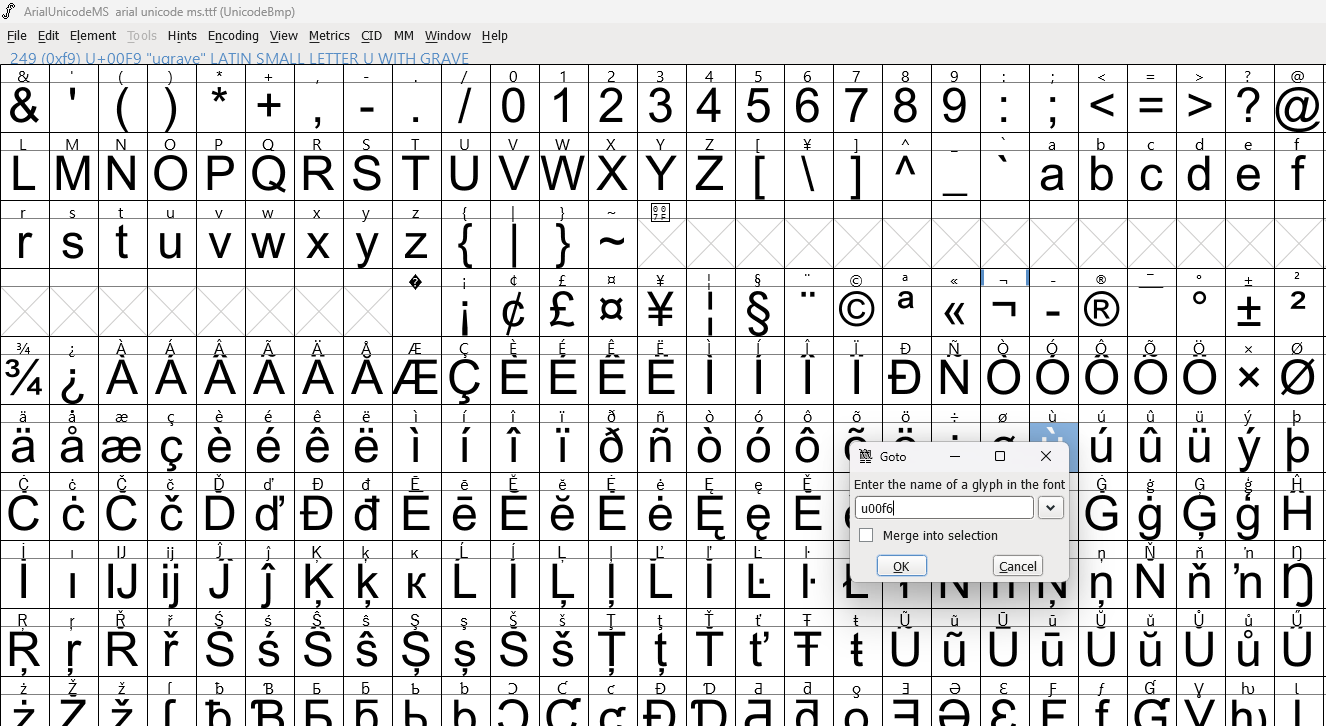 菜单栏View->Goto,输入unicode编码即可跳转到对应字符,比如上图的u00f6,点击ok即可。
隐藏空字符
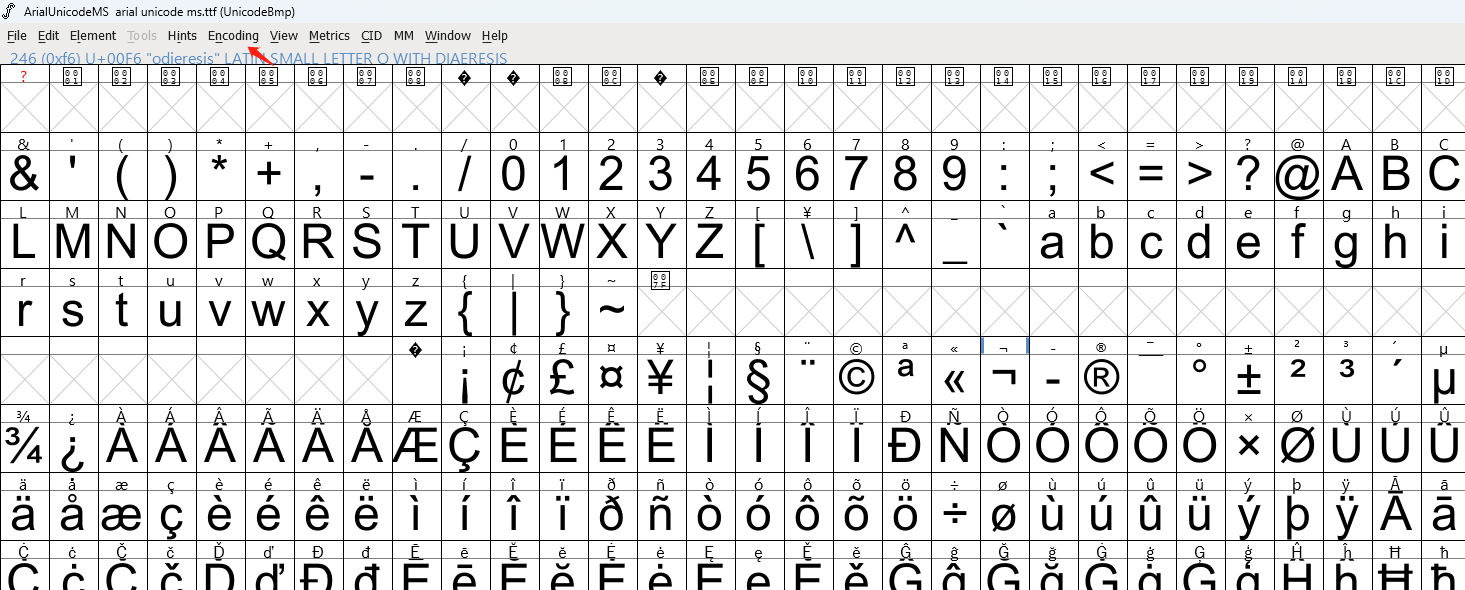
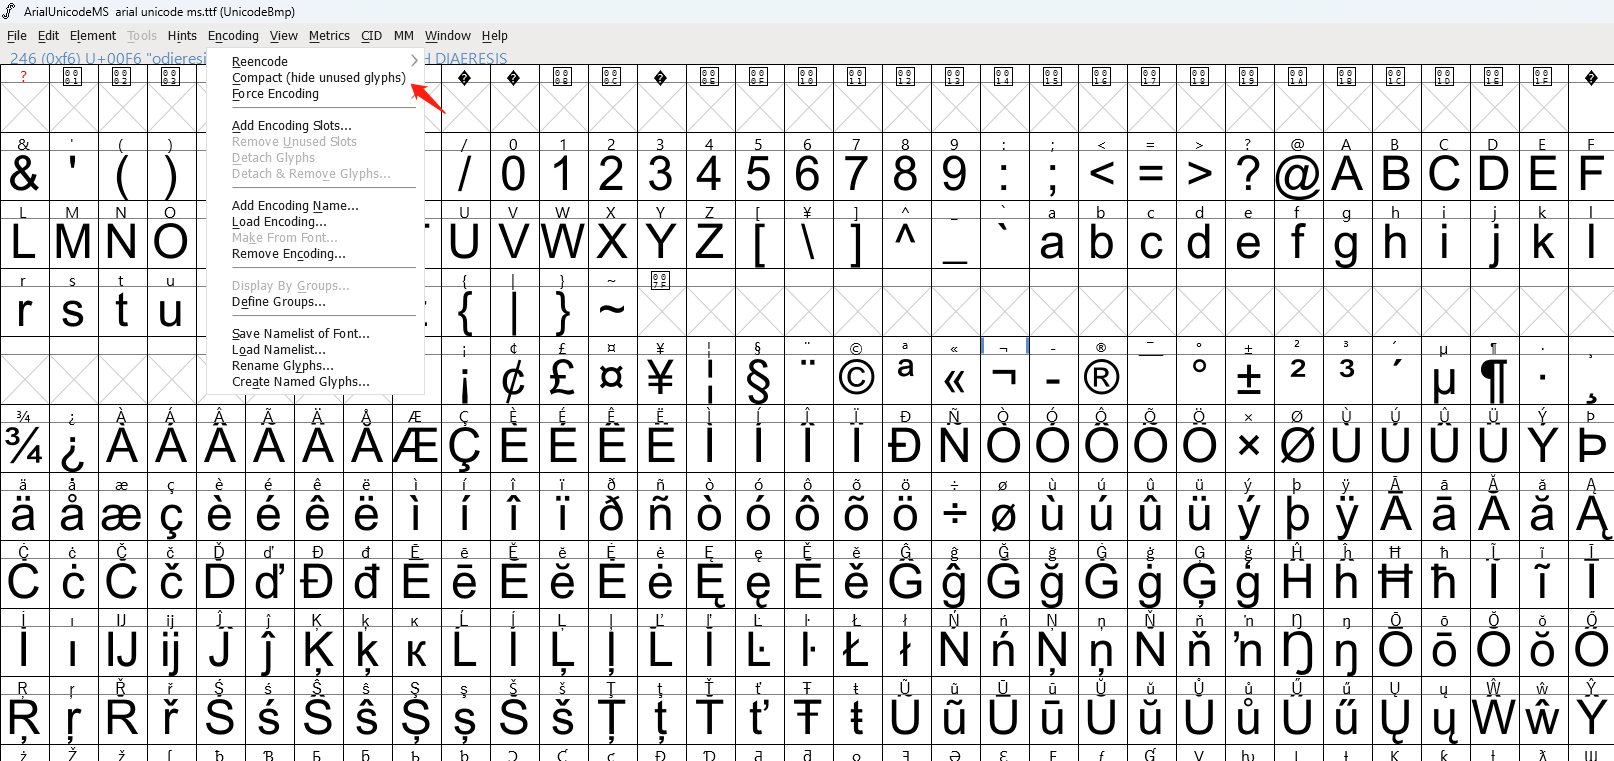
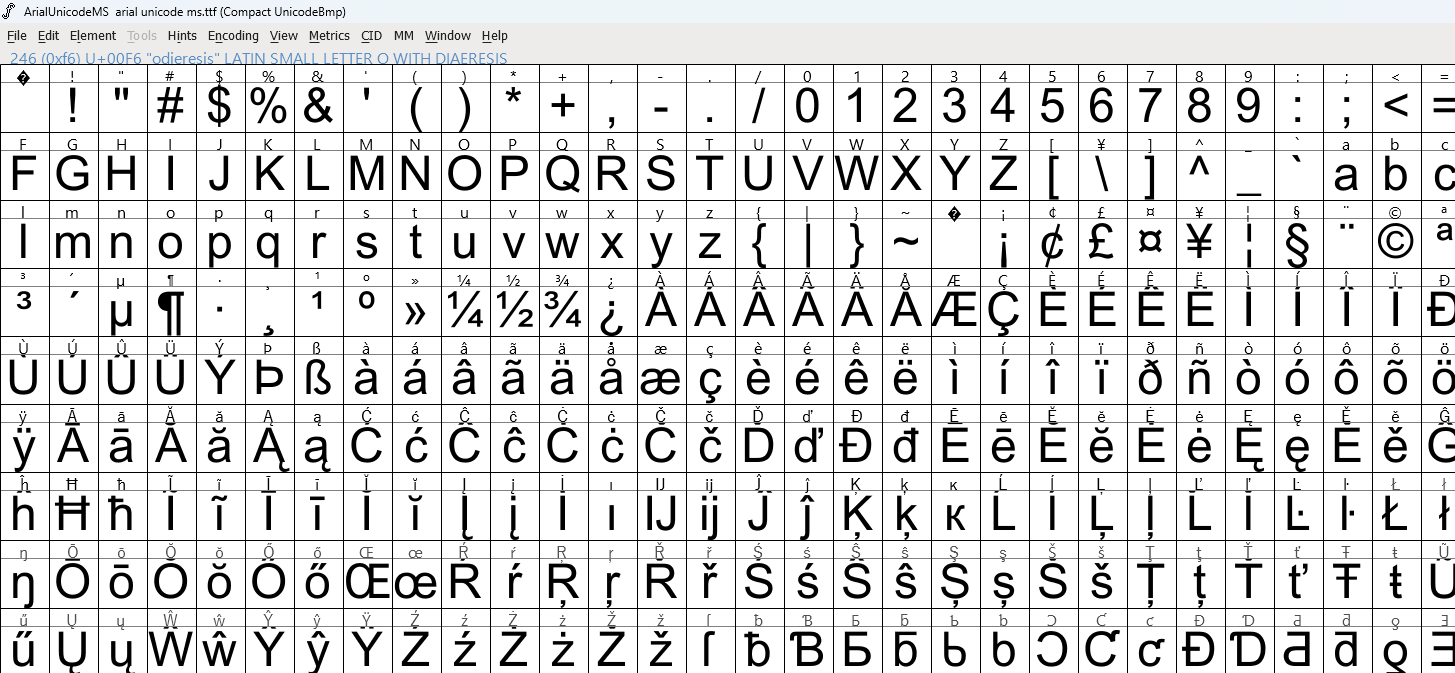 菜单栏Encoding->Compact(hide unused glyphs)即可隐藏空字符。
导出ttf非空字符的unicode编码范围
import fontforge

# 打开字体文件
font = fontforge.open("E:/ttf/KhmerUI.ttf") # 可以修改为自己ttf的路径

# 获取所有非空字符的Unicode编码
unicode_ranges = []
for glyph in font.glyphs():
    if glyph.unicode != -1:
        unicode_ranges.append(glyph.unicode)

# 导出Unicode编码范围
unicode_ranges.sort()
start_range = unicode_ranges[0]
end_range = unicode_ranges[0]
ranges = []
for i in range(1, len(unicode_ranges)):
    if unicode_ranges[i] == end_range + 1:
        end_range = unicode_ranges[i]
    else:
        ranges.append((start_range, end_range))
        start_range = unicode_ranges[i]
        end_range = unicode_ranges[i]
ranges.append((start_range, end_range))

# 打印Unicode编码范围
for start, end in ranges:
    print(f"{start}-{end}")

# 保存Unicode编码范围到文件,txt文件默认输出桌面,可以按需求修改
with open("C:/Users/admin/Desktop/unicode_ranges.txt", "w") as file:
    for start, end in ranges:
        file.write(f"{start}-{end}\n")

# 关闭字体文件
font.close()
把以上脚本复制下来,打开菜单栏File->Execute Script: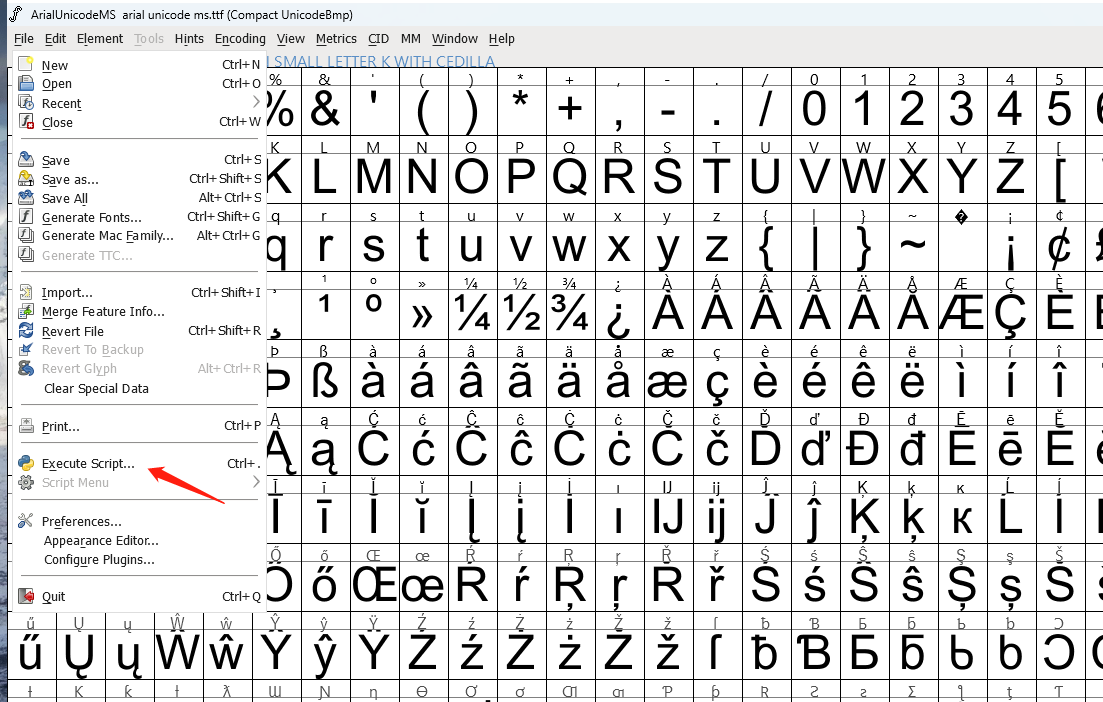
贴上对应脚本,点击ok即可: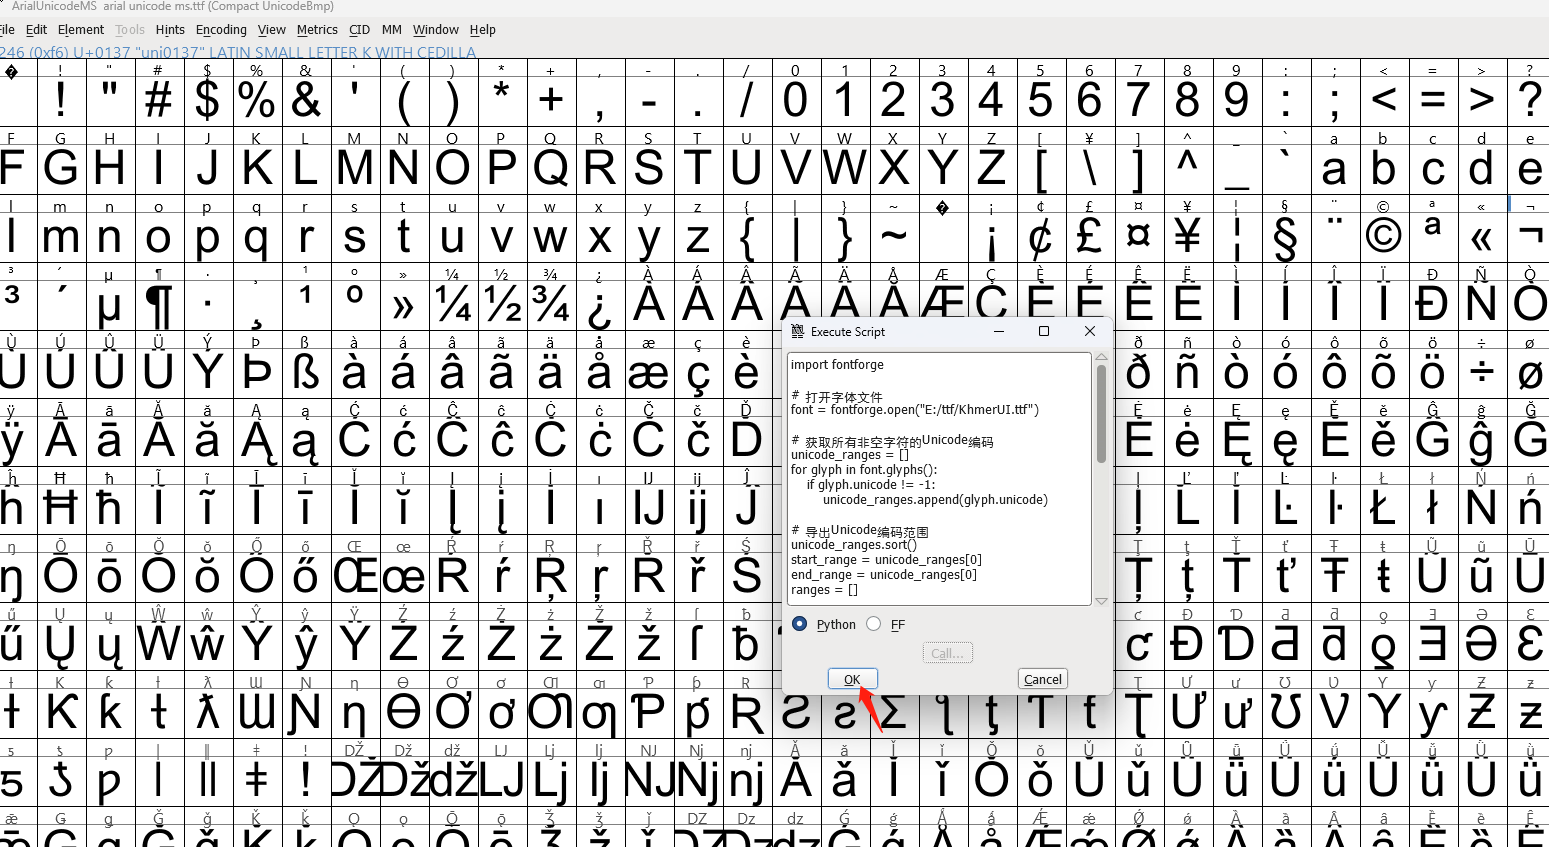
此时可以在桌面找到对应文件: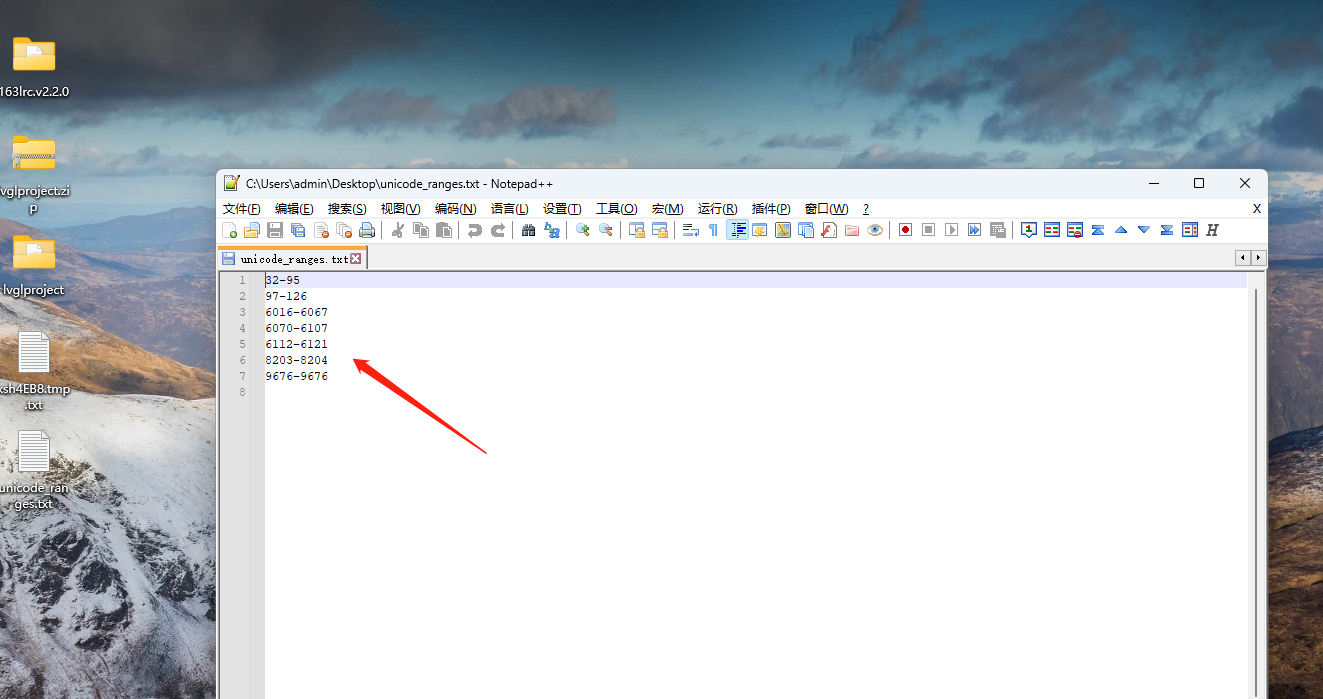 以上包含的就是当前ttf所包含的unicode编码范围。
也可以使用以下脚本一步到位,直接生成杰理字库工具所需要的xml文件:
import fontforge

# 输入输出路径需要根据用户路径来配置
input_path = r'D:/TTF/Indic.ttf'
output_path = r'D:/TTF/unicode_ranges.xml'

# @brief    合并连续编码,如0x0003 0x0004 0x0005合并为0x0003-0x0005
# @param    unicode编码列表
# @return   合并后的unicode编码列表
def merge_continuous(nums):
    intervals = [[nums[0]]]  # 初始化一个二维列表
    for num in nums[1:]:
        if num == intervals[-1][-1] + 0x1:  # 如当前数字与上一个区间的最后一个数字相差1,则将该数字添加到上一个区间
            intervals[-1].append(num)
        else:  # 否则新建一个区间并以当前数字为起始
            intervals.append([num])

    # 如果区间长度大于1则以‘起始值-结束值’的形式输出,否则只输出起始值
    return ['0x{:04X}-0x{:04X}'.format(x[0], x[-1]) if len(x) > 1 else '0x{:04X}'.format(x[0]) for x in intervals]

# @brief    转化为xml内容
# @param    unicode编码列表
# @return   合并后的unicode编码列表
def convert_to_xml(unicode_list):

    # 用于记录xml内容
    xml_content = ""

    # 遍历unicode编码列表
    for unicode_item in unicode_list:
        if '-' in unicode_item:  # 若内容包含‘-’则输出为“<Char>{起始值}-{结束值}</Char>”
            start_u, end_u = unicode_item.split('-')
            xml_content += f"\t<Char>{start_u}-{end_u}</Char>\n"
        else:  #否则输出<Char>{起始值}</Char>
            xml_content += f"\t<Char>{unicode_item}</Char>\n"

    # 去除头尾空格
    return xml_content.strip()

# 打开字体文件
font = fontforge.open(input_path) # 可以修改为自己ttf的路径

# 获取所有非空字符的Unicode编码
unicode_ranges = []
for glyph in font.glyphs():
    if glyph.unicode != -1:
        unicode_ranges.append(glyph.unicode)

# 导出Unicode编码范围
unicode_ranges.sort()

merged = merge_continuous(unicode_ranges)

# 保存Unicode编码范围到文件,txt文件默认输出桌面,可以按需求修改
with open(output_path, "w") as file:
    file.write('<?xml version="1.0" encoding="UTF-8"?>\n<CharSet>\n\t')
    # 转换为xml文件输出
    merged_str = convert_to_xml(merged)
    file.write(merged_str)

    # 写入xml结尾信息:
    # </CharSet>
    file.write('\n</CharSet>')

# 关闭字体文件
font.close()
其中用户需要将脚本开头的input_path和output_path分别配置为自己的ttf输入路径以及xml的输出路径,除了脚本不同以外其他操作均一致,生成xml格式如下: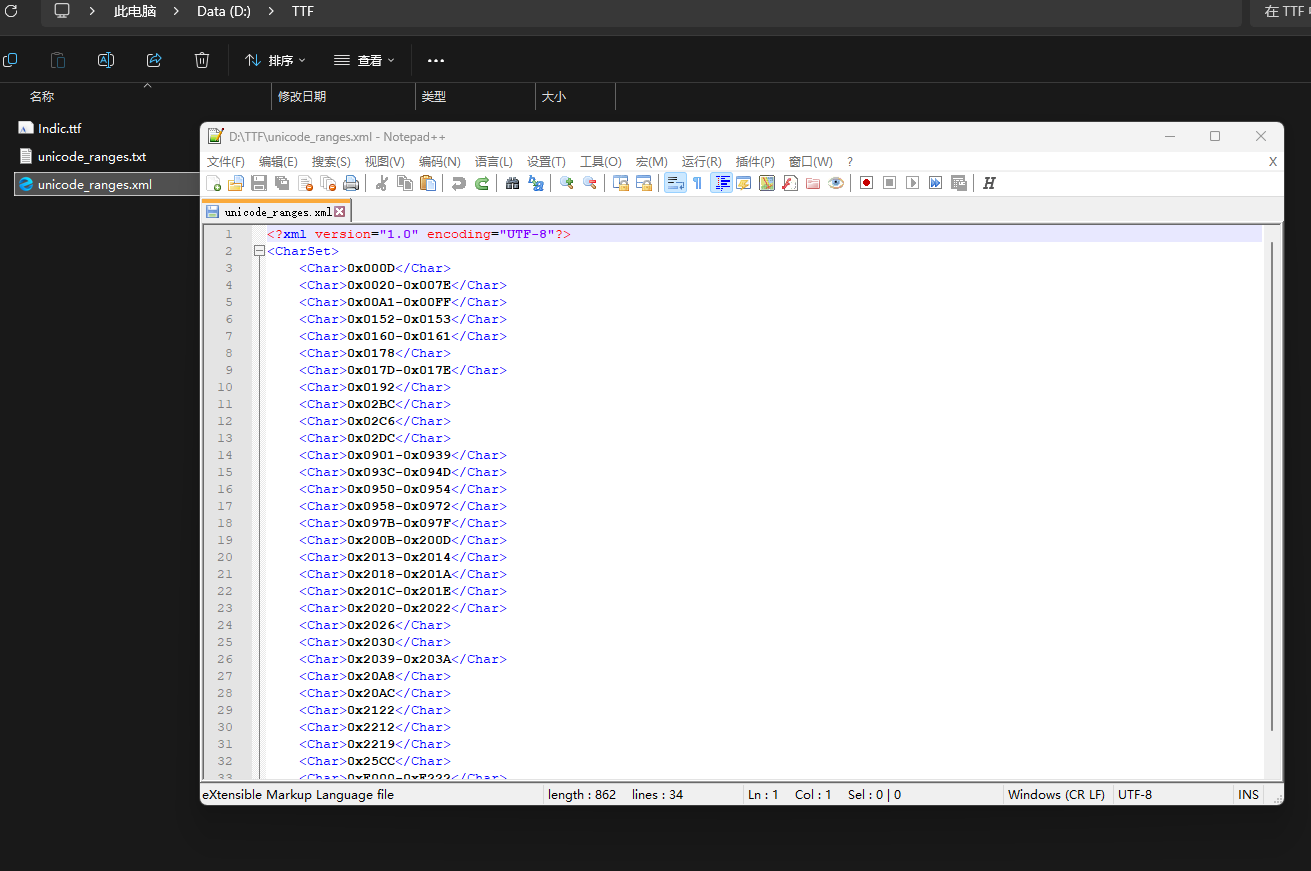
- 根据unicode编码范围裁剪.ttf文件
# main.py
import xml.etree.ElementTree as ET

input_file = r"D:/ttf/noto_hans.ttf" # 输入ttf路径
output_file = r"D:/ttf/noto_hans_simplified.ttf" # 输出ttf路径
xml_file = r"D:/ttf/config.xml" # 包含字符范围的xml文件

class TTFSubsetter:
    def __init__(self, input_file, output_file, xml_file):
        self.input_file = input_file
        self.output_file = output_file
        self.xml_file = xml_file
    def __extract_char_ranges(self):
        """提取字符串范围

        Args:
            xml_path (str): 输入xml文件路径

        Returns:
            list: 返回字符串范围列表
        """
        # 解析XML文件
        tree = ET.parse(self.xml_file)
        root = tree.getroot()

        # 提取Char元素内的文本内容
        char_ranges = [char.text for char in root.findall('Char')]

        return char_ranges

    def __convert_unicode_to_chars(self, unicode_list):
        """将unicode码点范围转码点列表

        Args:
            unicode_list (list): 输入unicode码点范围列表

        Returns:
            list: 返回码点列表
        """
        chars_list = []

        for item in unicode_list:
            if '-' in item:  # 处理编码范围
                start, end = item.split('-')
                start, end = int(start[2:], 16), int(end[2:], 16)
                for code_point in range(start, end + 1):
                    chars_list.append(code_point)
            else:  # 处理单个编码
                code_point = int(item[2:], 16)
                chars_list.append(code_point)

        return chars_list

    def __remove_unprintable_chars(self, s):
        """过滤不可见字符

        Args:
            s (list): 需要过滤的字符串列表

        Returns:
            list: 返回可见字符的字符串
        """
        return ''.join(char for char in s if char.isprintable())

    def get_xml_unicode(self):
        # 执行提取范围
        ranges_list = self.__extract_char_ranges()
        # 输出结果
        # print(ranges_list)

        # 转换并打印结果
        converted_chars = self.__convert_unicode_to_chars(ranges_list)
        # print(converted_chars)

        return set(converted_chars)

    def generate_subset_font(self, input_file, output_file, used_unicodes):
        font = fontforge.open(input_file)
        for char_name in font:
            glyph = font[char_name]
            unicode = glyph.unicode
            if unicode  not in used_unicodes:
                glyph.clear()

        font.generate(output_file)
        font.close()

if __name__ == "__main__":
    ttf_subbetter = TTFSubsetter(input_file, output_file, xml_file)
    used_chars = ttf_subbetter.get_xml_unicode()
    ttf_subbetter.generate_subset_font(input_file, output_file, used_chars)
用户需要手动修改input_file,output_file和xml_file的路径,分别为输入原始.ttf文件,输出裁剪后的.ttf文件,设置裁剪范围.xml文件的路径。
其中config.xml示例如下,xml中出现的unicode码点为要保留的码点:
<?xml version="1.0" encoding="UTF-8"?>
<CharSet>
    <Char>0x0020</Char>
    <Char>0x002D</Char>
    <Char>0x0061-0x007A</Char>
</CharSet>
裁剪前.ttf如下: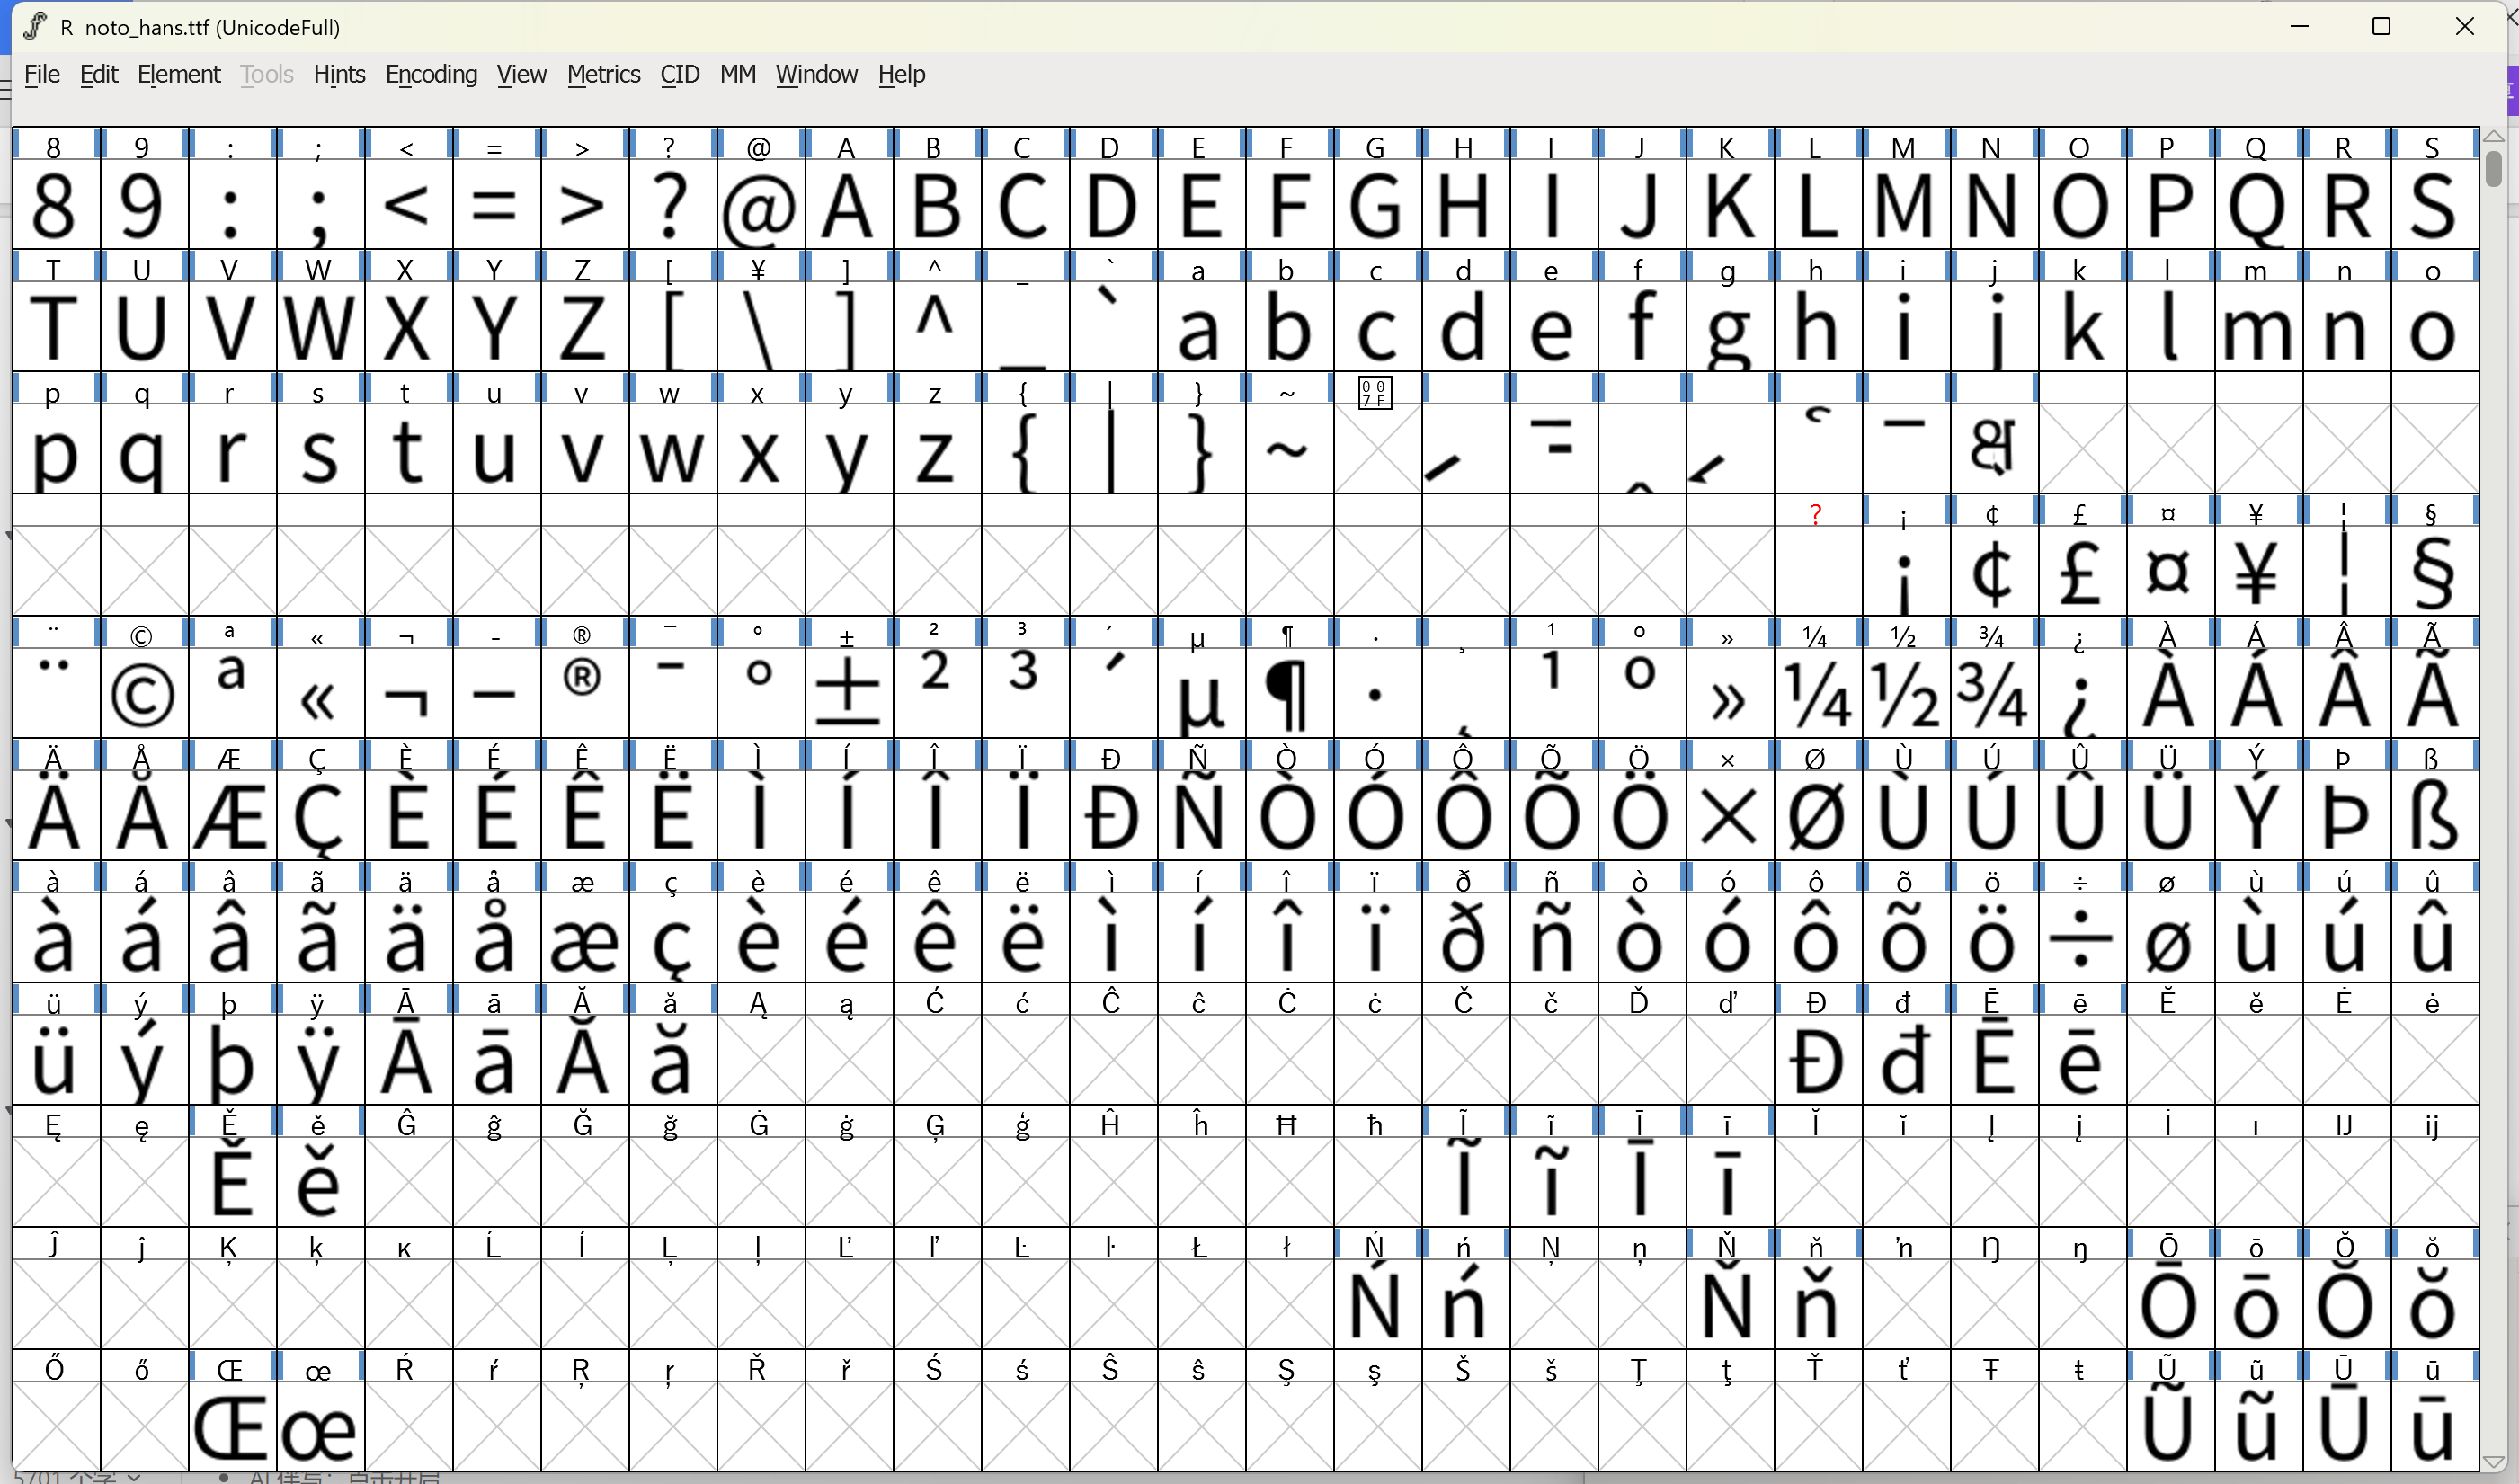 裁剪后.ttf文件如下:
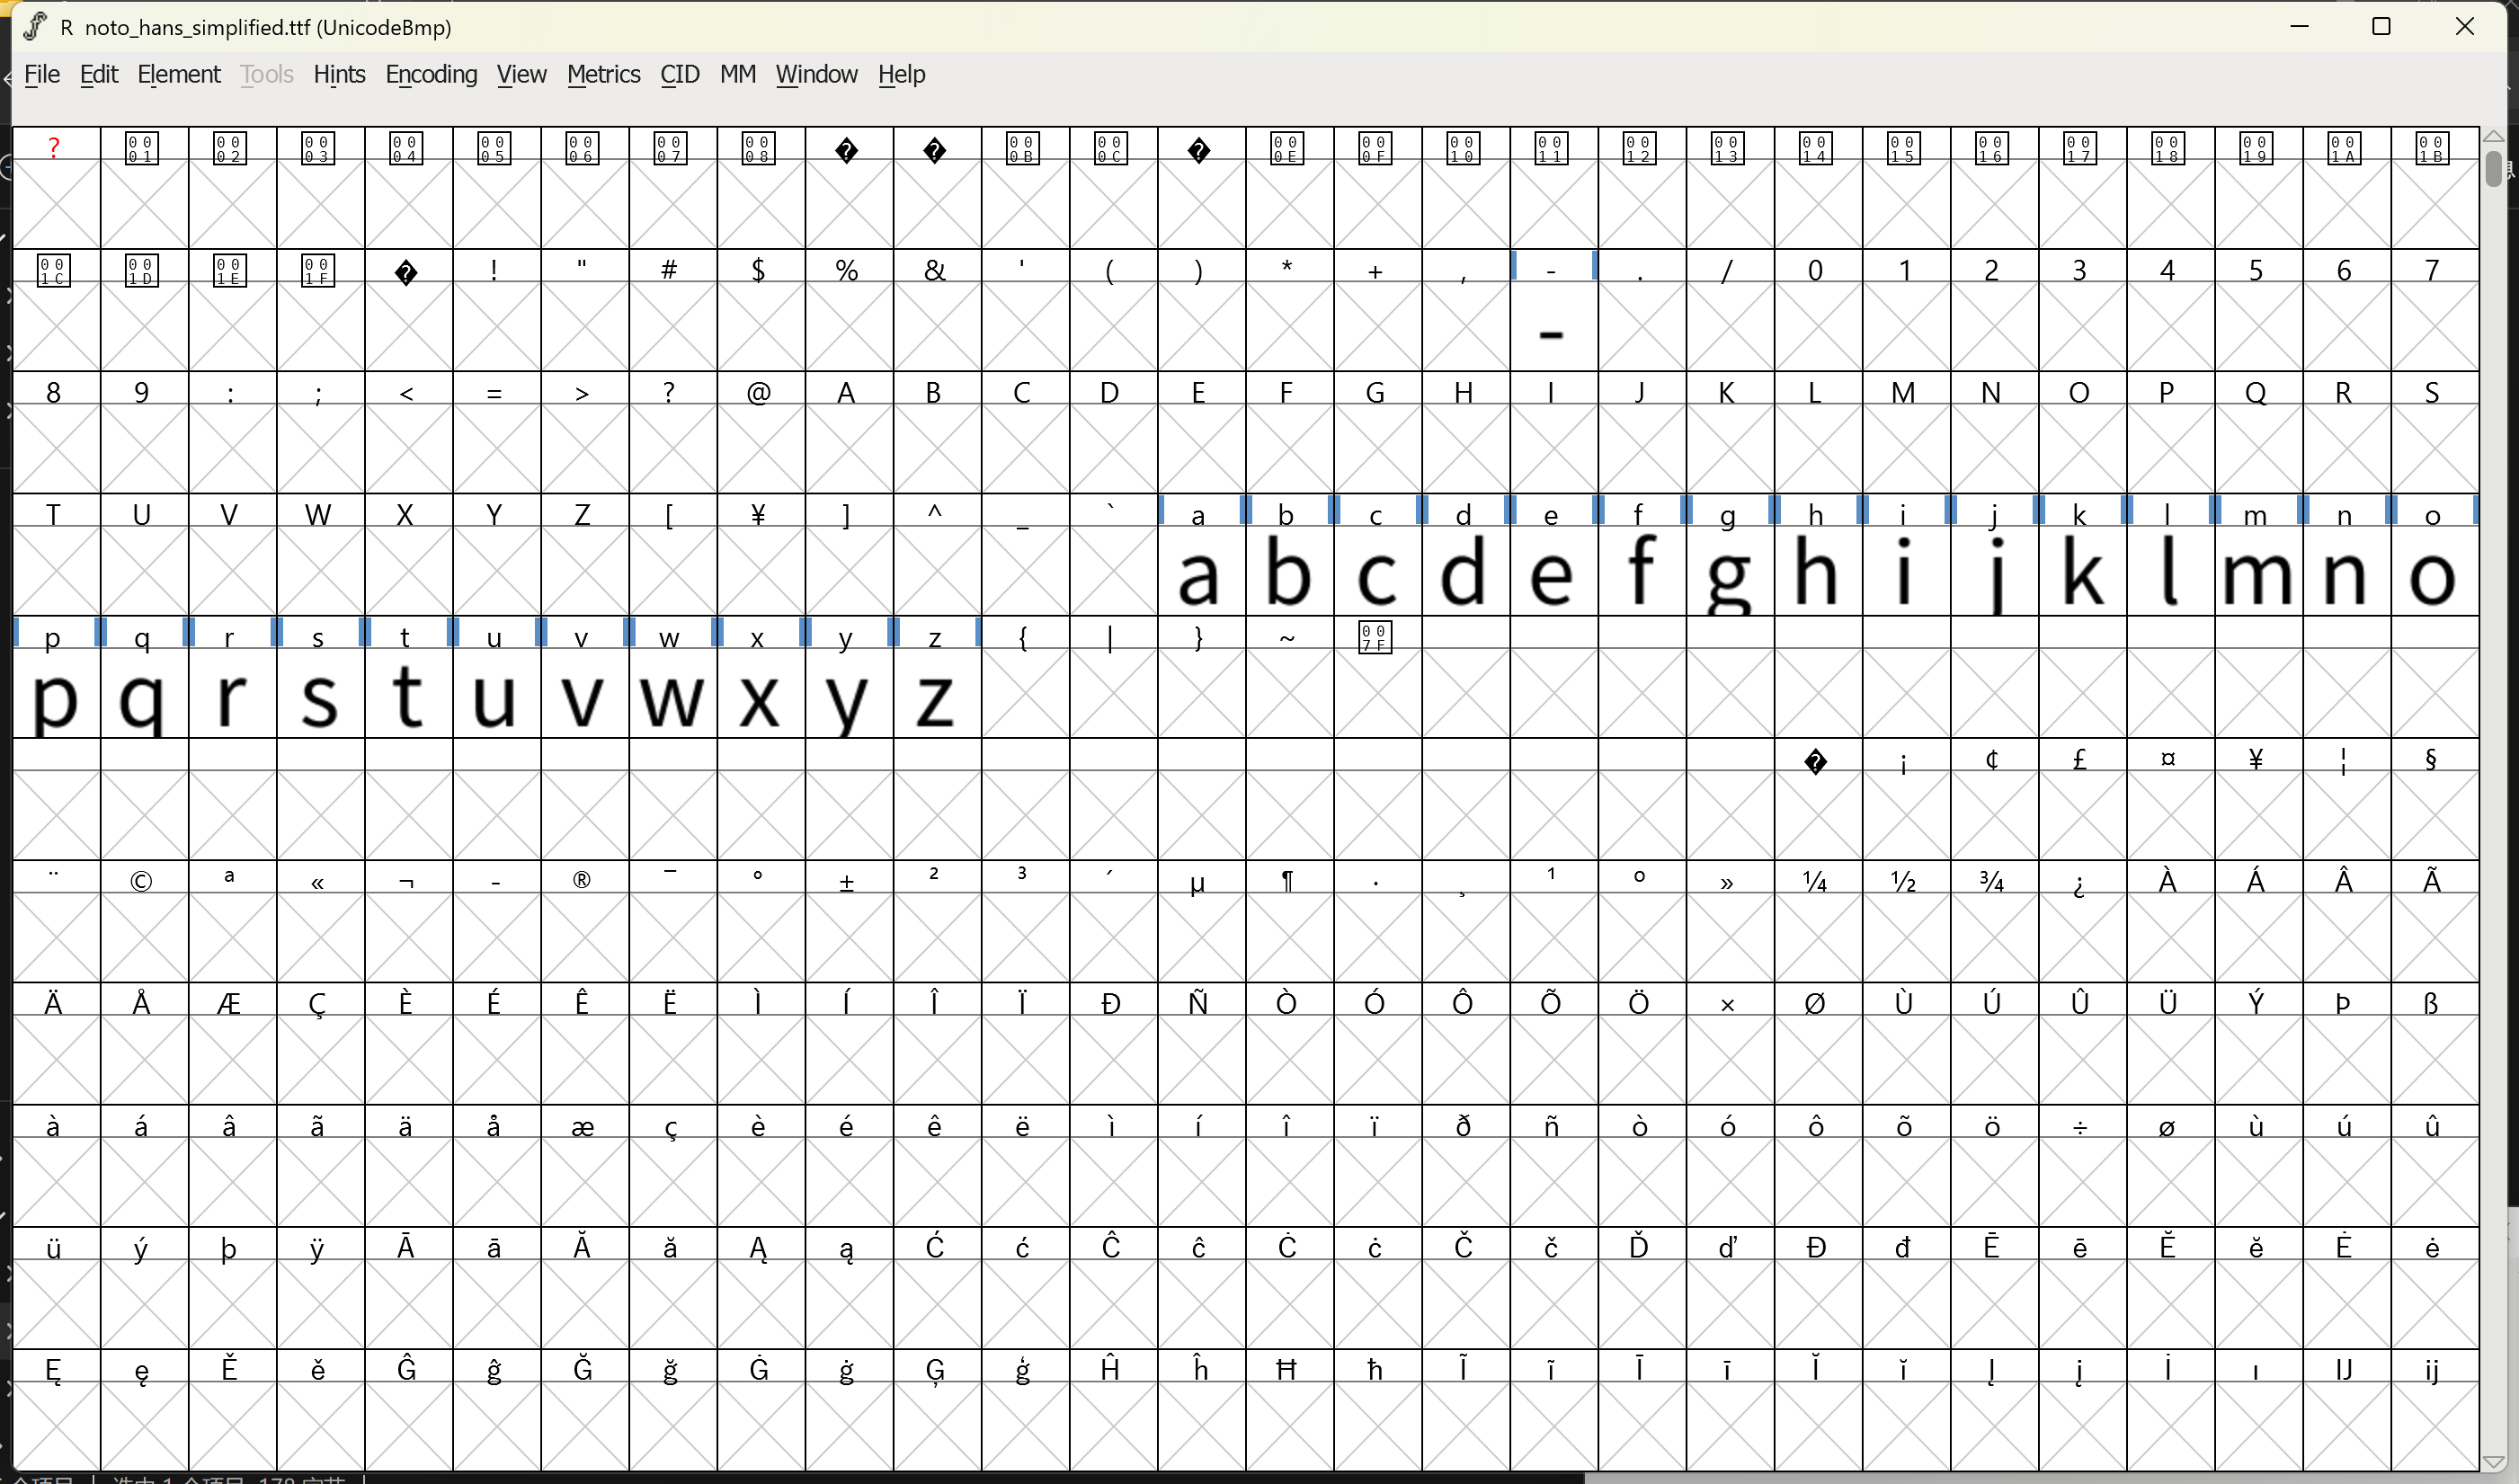 如上,使用该脚本基本可以满足将.ttf文件按照设定unicode范围进行裁剪的需求。
(五)常见问题:
“直”字、“将”字显示为另一种字形
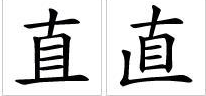
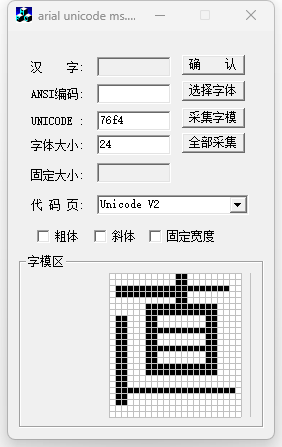
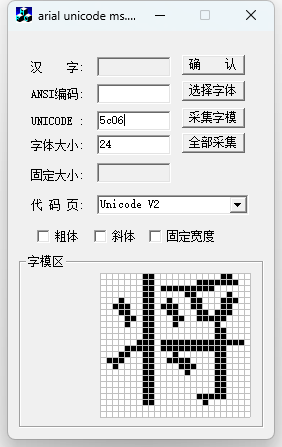
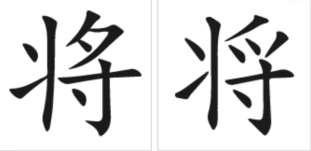 如上图,右边的为“直”和“将”的另一种写法,若显示右边的字形,请检查中文的ttf是否为arial unicode ms.ttf,因为该ttf含有的字模就是“直”和“将”的另一种字形,如下图所示:
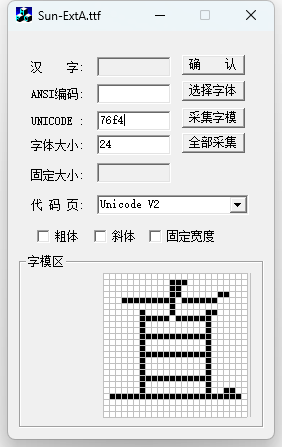
 对于这种情况可以直接更换ttf文件来解决,在Sun-ExtA.ttf的情况下预览这两个字符,如下所示:
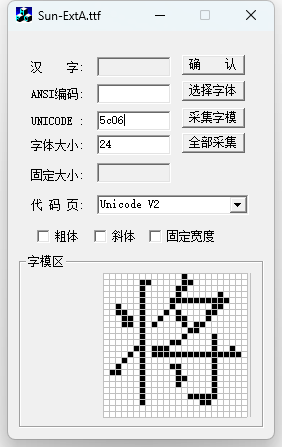
输入字符不显示或者显示“_” 遇到这种情况先从以下几个步骤进行排查:
a.打印font_lang_get(),查看当前设置语言是否支持当前字符显示,若不支持,则需用font_lang_set()切换到相应语言,也可直接设置为Unicode id(即font_lang_set(Unicode))支持显示所有语言的字符,先排除语言设置错误的问题;
b.若确保了语言没有设置错误的情况下,仍然显示不出来,则把字符串编码putbuf出来,留意是否存在对应字符编码,若不存在对应编码则需排查传输过来的字符串在哪个环节缺失了字符,比如是app传过来时缺失了某个字符,还是存储阶段对字符串进行了处理导致丢失等;
c.若存在对应编码但没有显示则需考虑是否是没有配置中没有包含对应编码,可以在.xml文件中查找是否包含了缺失字符的unicode码,或者是ttf文件里不包含对应字符,可以选择对应ttf后在FontTool.exe中输入对应字符unicode码在预览中查找,若查找不到则说明当前ttf不包含对应字符的字模,需要更换包含该字符的ttf文件。如何查看unicode字库支持什么语言 unicode字库支持所有代码页显示,公版sdk中的language_list.h里面提供了一些基本的语言,但其实很多语言都是使用同一份驱动的,也就是说,这些语言用到的字符都是一样的,只是语法、语义存在差异,而字库仅仅是提供了支持这一类字符的显示功能,至于怎么排序,构成对应语言合法的语义,则是看用户如何去排列这些字符。举个例子,在英语里面,“你好”对应的是“hello”,法语里面则是“bonjour”,可见两者之间只是存在语法和语义上的差别,实际上用到的都是拉丁语系的字符,故切换到1252代码页即可显示,对应的English和Unicode这两个id都能满足当前需求。那么如何确定unicode字库是否支持某种特定语言呢?可以根据下面步骤进行判断:
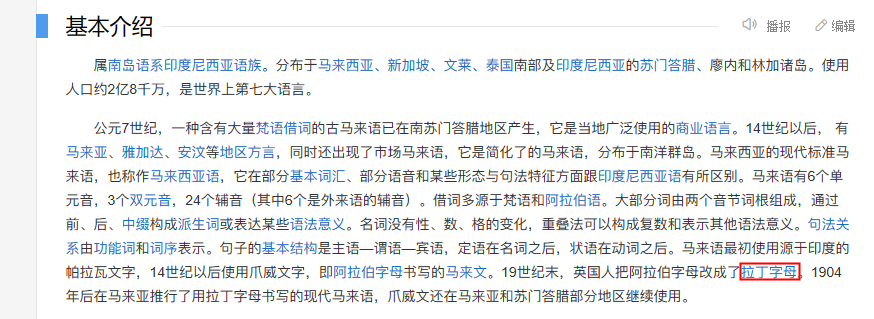
a.直接在Codepage.txt中查询该语言(简写和全称都查询一下),在字符映射表中能够找到的则是已支持的语言;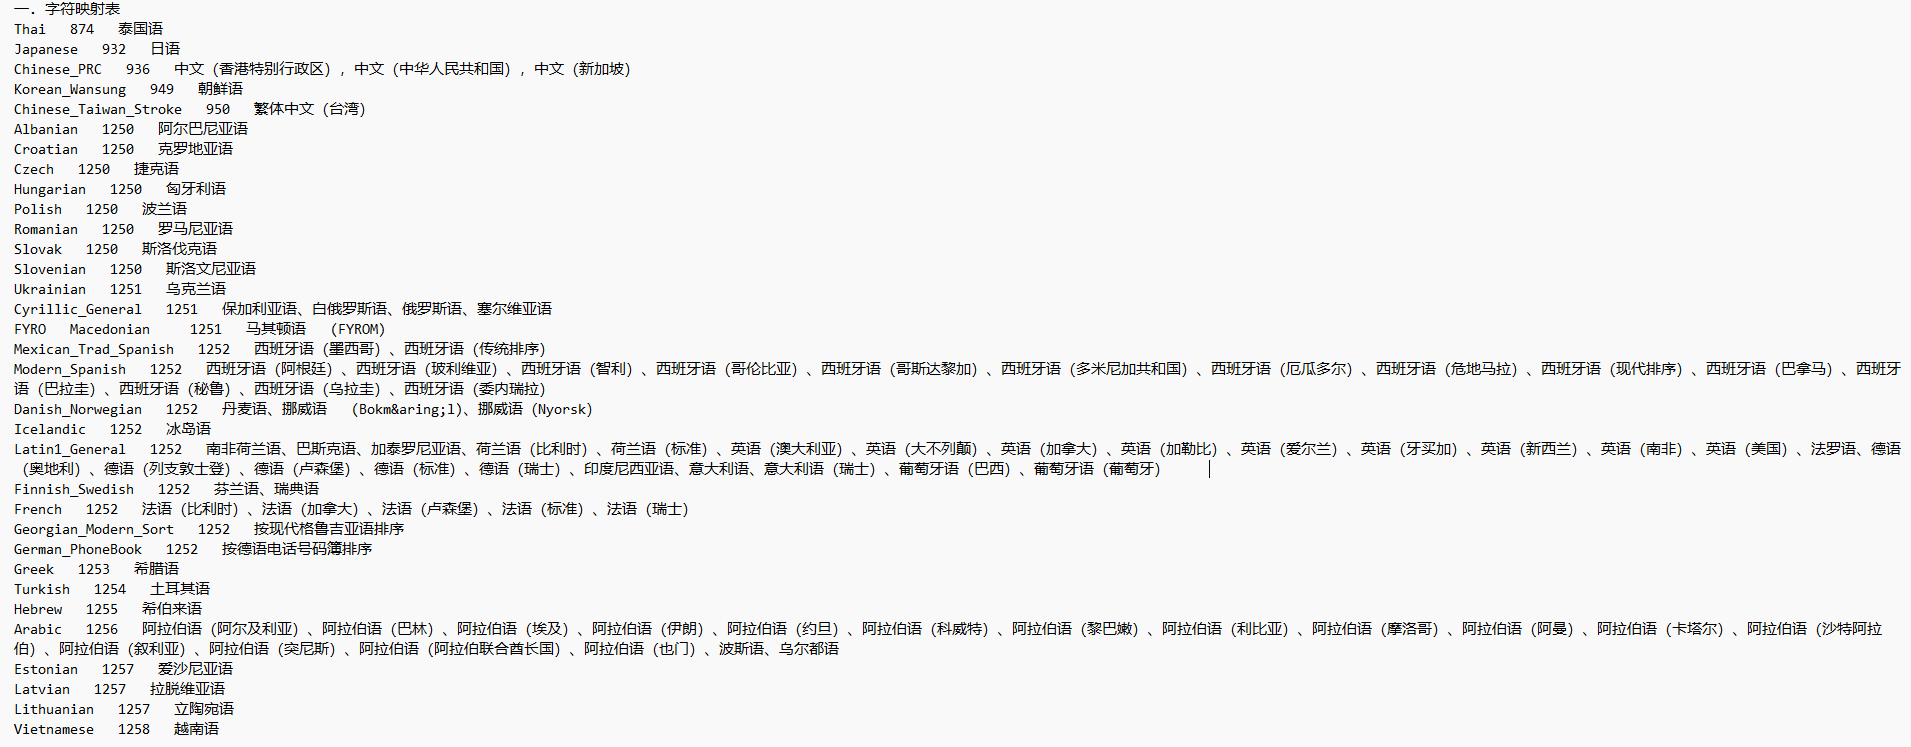 b.若无法在Codepage.txt中找到,则可以在百度中按照“目标语言 + 字母 / 字符 / 代码页”等关键词方式去查找,若目标语言所用代码页被Codepage.txt所包含,则支持该语言。如查询马来语,该语言在Codepage.txt中找不到,但可以了解到该语言采用的也是拉丁字母,初步确认采用1252可以显示马来语,后续可以进一步确认是否还有用到其他代码页,如有则继续添加上即可。
为什么使用字库时俄语字符间隔比较大?如何缩小间隔 该问题可能是ttf中字模本身带有间隙导致,请更换1251的ttf后再次尝试。
为什么字模提取工具采集到一半突然闪退?字模文件也没有生成 以下面选择系统自带的黑体为默认字体为例:
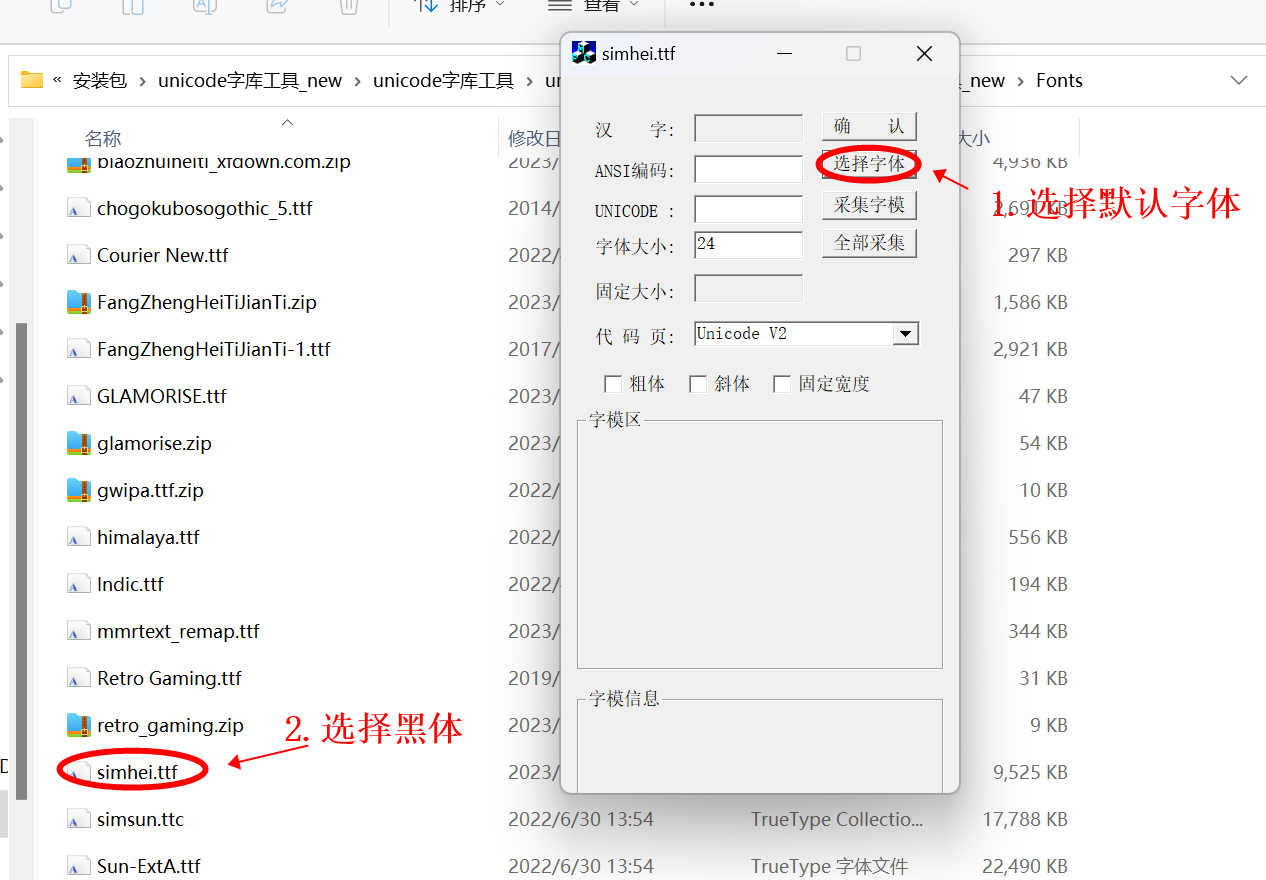 采集过程中闪退,一般是因为在一些编码范围内,当前选择的ttf并没有提供相应字模,导致工具“罢工”了,用ttf查看工具(开源ttf查看工具链接在文档顶部)可以看到,该simhei.ttf在9fa6后面开始就没有相应的字模了,没有相应字模,工具自然也无法采集出来。
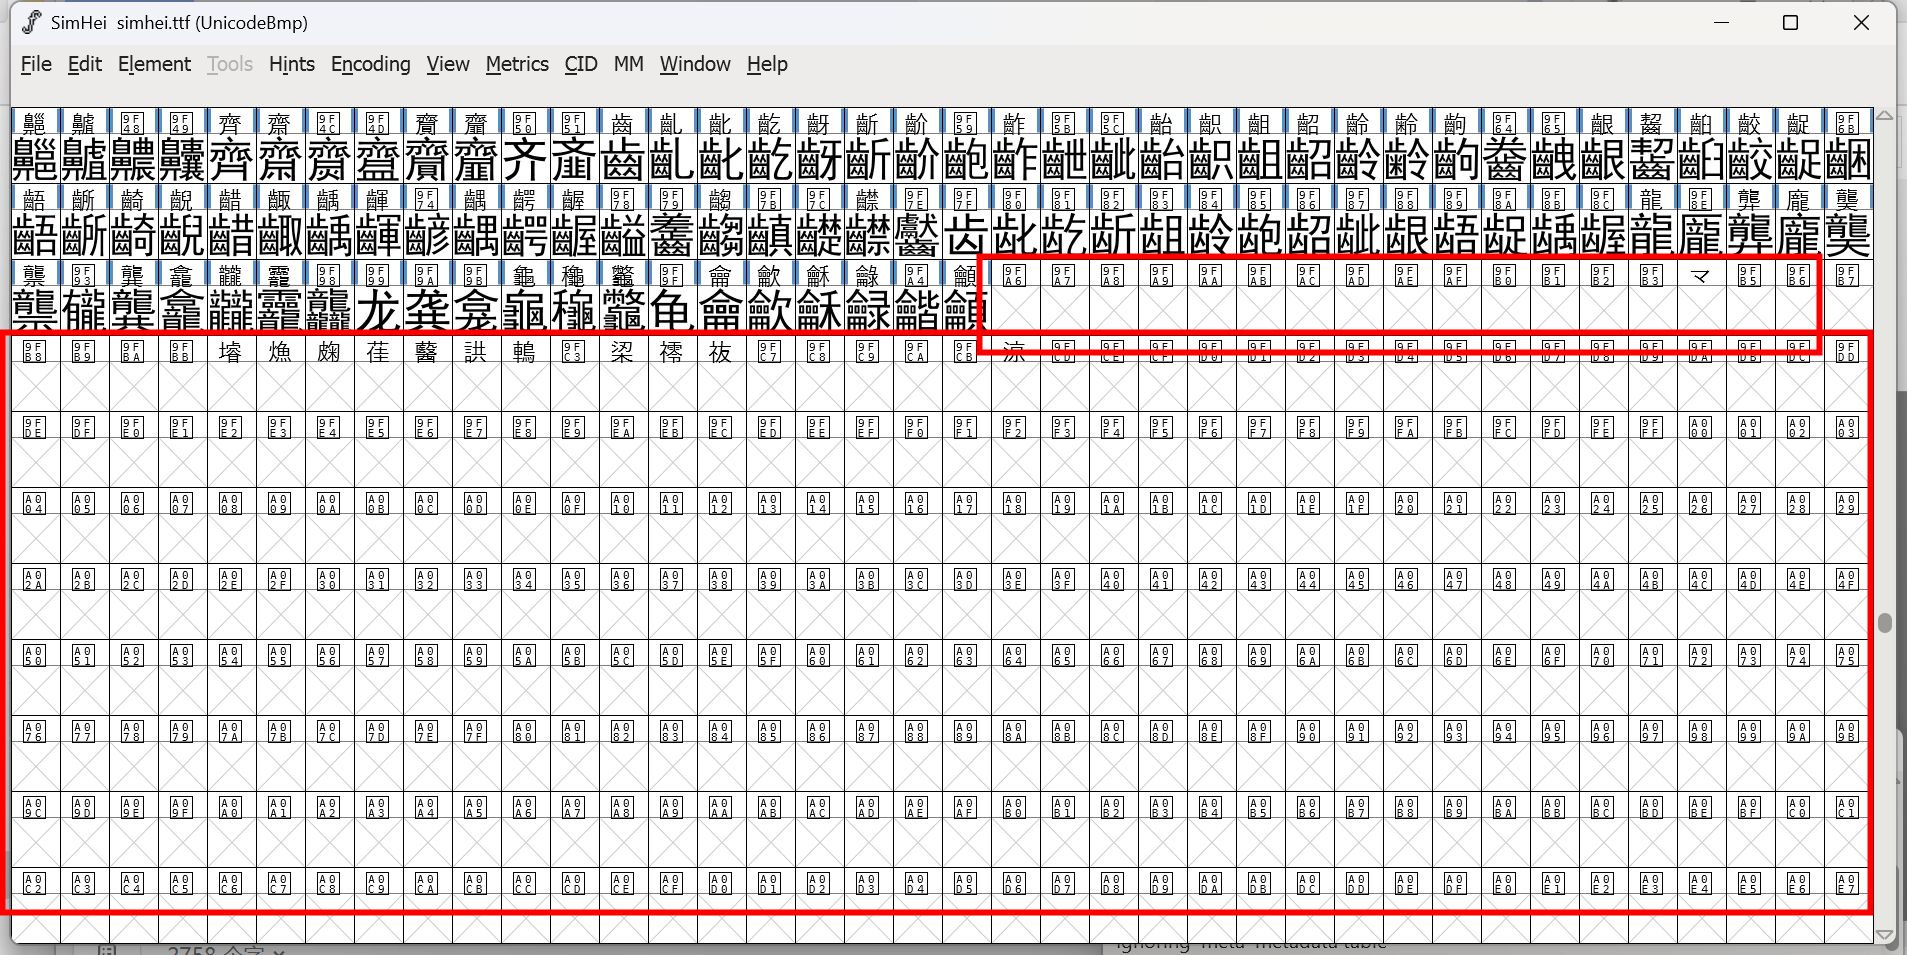 除此之外,在font.xml配置中,某个代码页配置了相应的ttf,但在对应路径下如果没有找到对应的ttf,也会出现找不到字模的情况。
这个时候就需要确认Fonts文件夹下是否包含了font.xml中用到的所有ttf,以及对应ttf是否提供相应字模,如果没用提供相应字模,则需要更换ttf,确保ttf提供所选代码页包含的编码范围都有相应字模,这样字模提取工具才能够正常工作,又或者在charset路径下把ttf中没有字模的编码给去掉,让工具不采集这部分编码。
解决步骤:
确定卡死前的编码
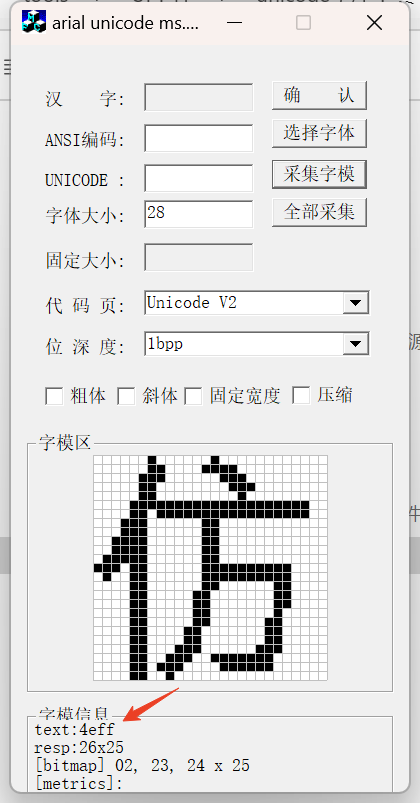 假设卡死前停在“仿”字,这里会打印出“仿”字的unicode编码,即4eff,此时可以参考 fontforge根据字符查找编码(点击跳转)的方式查看ttf,检查ttf是否该字符后的字符大片空字符,以确定是否是该问题导致的死机。
若在fonttool.exe中看不到“字模信息”这一栏目,可以调整电脑屏幕缩放比例: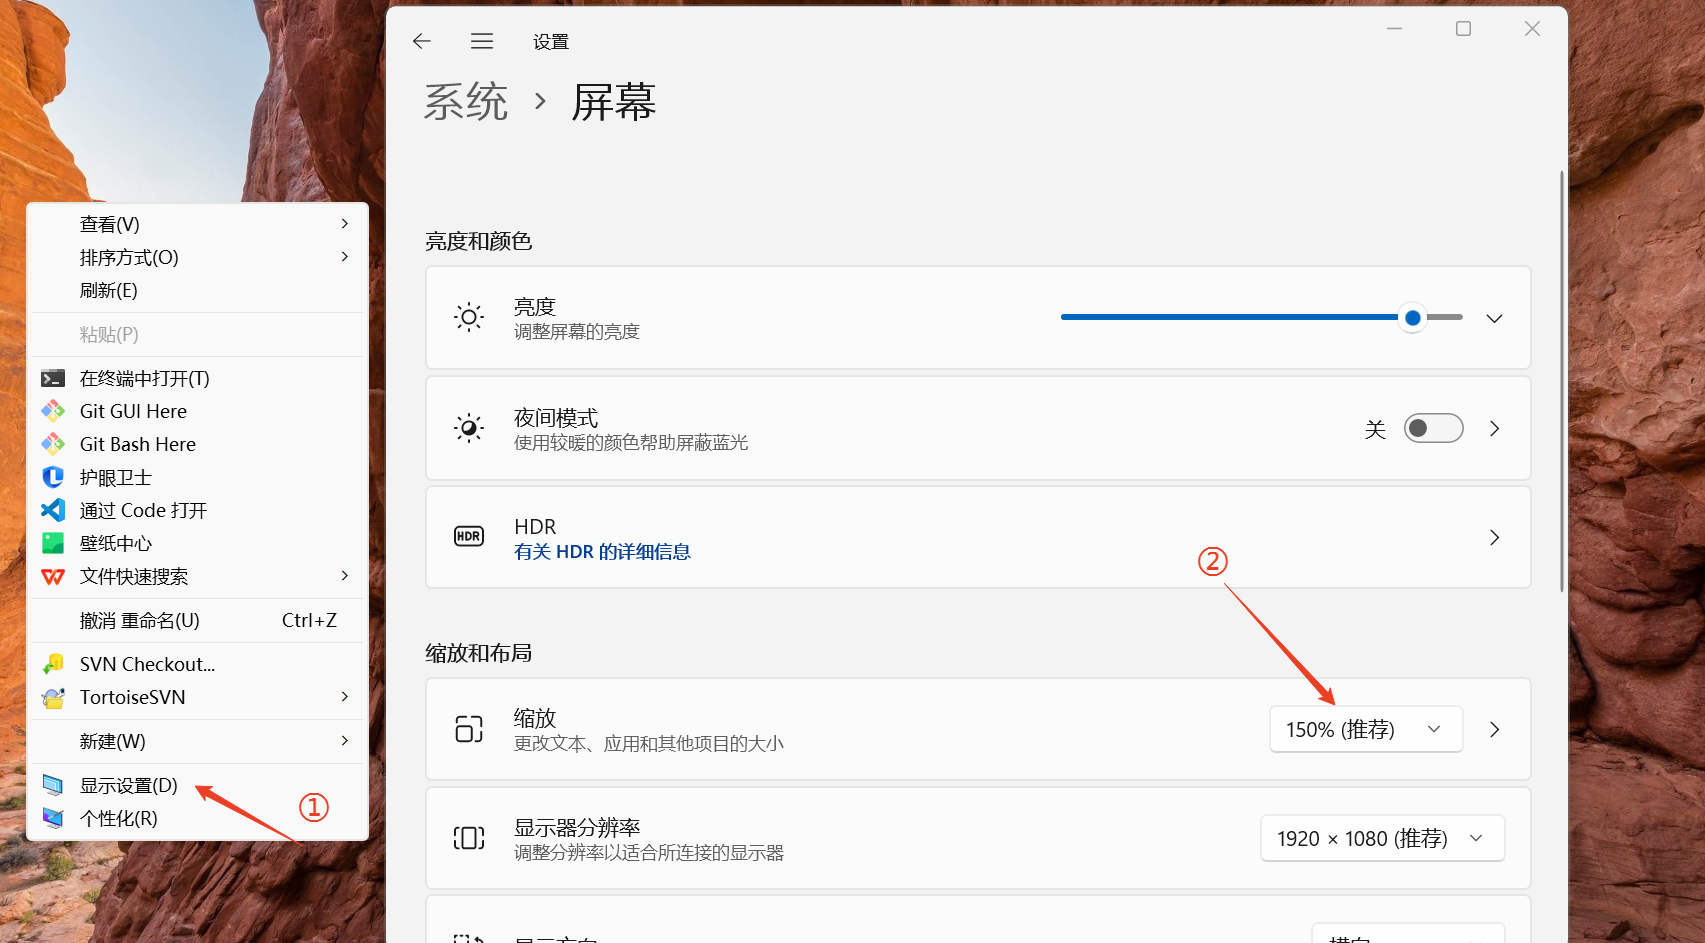 右键->显示设置->缩放和布局中缩放比例设置为150%,即可见到“字模信息”栏目。
若确定是ttf字模大片缺失引起,则可以参考 导出ttf非空字符的unicode编码(点击跳转) 的方式将ttf的unicode编码范围导出到.xml文件中,替换掉对应代码页的.xml,如ttf是中文简体-思源黑体的,生成出来的 思源黑体.xml,替换掉则用思源黑体.xml的内容替换gb2312.xml的内容,此时就不会按照原本gb2312.xml的内容进行提取,导致闪退,当然也可以找一个全一些的ttf文件,包含gb2312.xml中绝大部分的字模,也可以保证正常采集。
待补充