GPU模块介绍
📎 原始文档:https://www.kdocs.cn/l/cp5VVR6MrCwY GPU模块介绍
具体文档参考:
file:///D:/APP/JLStudio/JLStudio/standard/watch/AC707N/1.0.0/docs/html/SDK/watch/module/GPU/index.html
一、GPU模块介绍
GPU模块,主要用于图像处理,负责图像的变换、叠加等运算。
- 基于指令链表,减少CPU开销,渲染性能 1pixel/cycle;
- 高密度指令集,减少内存开销;
- 支持仿射变换(2D)、透视变换(2.5D),采用变换矩阵进行控制;
- 支持多种颜色格式输入(19种),输出(6种);
- 支持多种压缩方式,可灵活选择大小优先/性能优先;
- 支持多种混合模式,灵活处理前景、背景透明度计算;
- 支持颜色格式大小端(bpp<8 or RGB565)或RED-BULE交换;
- 支持纯色填充、MASK、线性渐变、纹理、纹理裁剪等功能;
- 支持非连续数据(采用mmu tab表)输入;
- 支持硬件从SRAM/PSRAM、NORFLASH存储介质读取数据;
- 支持GPU断点指令功能,允许在GPU任务链允许中断、恢复,插入CPU操作;
- 支持colorkey、dither等拓展功能。
二、GPU模块说明
任务与任务链表
- GPU硬件模块采用任务链表配置方式,每个任务各由一组指令参数描述,驱动中体现为一个GPU任务单元。
- GPU硬件模块启动后,会自动将任务链表中的所有任务绘制完毕,可无需CPU参与,便于GPU绘制和CPU配置指令并行处理。
- 如需要在GPU绘制过程中,插入CPU操作,可采用GPU任务断点功能,中断GPU绘制,处理完CPU操作后再继续绘制。
- 任务支持十种功能:纯色填充、纯色填充+MASK、纯色填充+仿射变换、纯色填充+透视变换、线性渐变填充、线性渐变填充+透视变换、纹理填充、纹理填充+MASK、纹理填充+仿射变换、纹理填充+透视变换。
| 功能 | 定义 |
|---|---|
| 纯色填充 | GPU_FILL |
| 纯色填充+MASK | GPU_FILL_MASK |
| 纯色填充+仿射变换 | GPU_FILL_AFFINE |
| 纯色填充+透视变换 | GPU_FILL_PERSPECTIVE |
| 线性渐变填充 | GPU_LINEGRAD |
| 线性渐变填充+透视变换 | GPU_LINEGRAD_PERSPECTIVE |
| 纹理填充 | GPU_TEXTURE |
| 纹理填充+MASK | GPU_TEXTURE_MASK |
| 纹理填充+仿射变换 | GPU_TEXTURE_AFFINE |
| 纹理填充+透视变换 | GPU_TEXTURE_PERSPECTIVE |
GPU支持的格式
| 格式 | 描述 | 输出 | 索引格式 | 颜色表格式 | MASK |
|---|---|---|---|---|---|
| ARGB8888 | 24位真彩色+8位alpha | 是 | |||
| ARGB8565 | 16位真彩色+8位alpha | 是 | 是 | ||
| ARGB1555 | 15位真彩色+1位alpha | ||||
| ARGB4444 | 12位真彩色+4位alpha | ||||
| RGB888 | 24位真彩色 | 是 | |||
| RGB565 | 16位真彩色 | 是 | 是 | ||
| YUV422_BT601 | YUV数据,BT601标准 | ||||
| YUV422_BT709 | YUV数据,BT709标准 | ||||
| AL88 | 8位颜色表+8位alpha | 是 | |||
| AL44 | 4位颜色表+4位alpha | 是 | |||
| AL22 | 2位颜色表+2位alpha | 是 | |||
| L8 | 8位颜色表 | 是 | |||
| L4 | 4位颜色表 | 是 | |||
| L2 | 2位颜色表 | 是 | |||
| L1 | 1位颜色表 | 是 | |||
| A8 | 8位alpha | 是 | 是 | ||
| A4 | 4位alpha | 是 | 是 | ||
| A2 | 2位alpha | 是 | 是 | ||
| A1 | 1位alpha | 是 | 是 |
混合模式
| 混合模式 | 公式 | 说明 |
|---|---|---|
| GPU_BLEND_SRC | a_out = a_fg c_out = c_fg | 只显示src图像 |
| GPU_BLEND_SRC_OVER | a_out = a_fg + (1 - a_fg) * a_bg c_out = c_fg + (1 - a_fg) * c_bg | 按src的透明度将src与dst混合输出 |
| GPU_BLEND_DST_OUT | a_out = (1 - a_fg) * a_bg c_out = (1 - a_fg) * c_bg | 显示dst图像,但只显示src和dst的不重合部分,且重合部分只有src是不透明的才算重合 |
| GPU_BLEND_DST_IN | a_out = a_fg * a_bg c_out = a_fg * c_bg | 只显示src和dst重合部分,且src的重合部分只有不透明度有用 |
| GPU_BLEND_MAX | a_out = MAX(a_fg, a_bg) c_out = c_bg | 取dst与src的alpha最大值输出 |
| GPU_BLEND_DST_OVER | a_out = (1 - a_bg) * a_fg + a_bg c_out = (1 - a_bg) * c_fg + c_bg | 与src_over相反 |
| GPU_BLEND_SRC_OUT | a_out = (1 - a_bg) * a_fg c_out = (1 - a_bg) * c_fg | 显示src图像,但只显示src和dst的不重合部分,且重合部分只有dst是不透明的才算重合 |
| GPU_BLEND_SRC_IN | a_out = a_bg * a_fg c_out = a_bg * c_fg | 只显示src和dst重合部分,且dst的重合部分只有不透明度有用。 |
- 注:fg:前景;bg:后景;out:输出;a:alpha;c:color;src 前景;dst 后景;
三、函数接口
- 707N系列GPU驱动提供了类似701N-IMB模块的任务链管理逻辑,方便701N系列用户环境移植;
- 707N系列推屏模块命名为DBI模块,功能与701N系列IMD模块类似,主要用于硬件推屏,但需注意DBI模块API使用与701系列存在区别(具体使用方法,参照DBI模块介绍);
- 开始推屏时,用lcd_set_draw_area设置本次推屏的整个区域即可,无需每次推屏都设置推屏区域;
- 第一分块推屏时,使用lcd_draw_kistart启动DBI模块推屏;
- 其它分块推屏时,使用lcd_draw_continue接口进行续传即可;
- 可参考SDK gpu_task.c 推屏逻辑,lcd_xxx前缀API的调用逻辑。 ==注意:DBI模块区域参数为(xstart, xend, ystart, yend)形式,非(x, y, width, height)!==
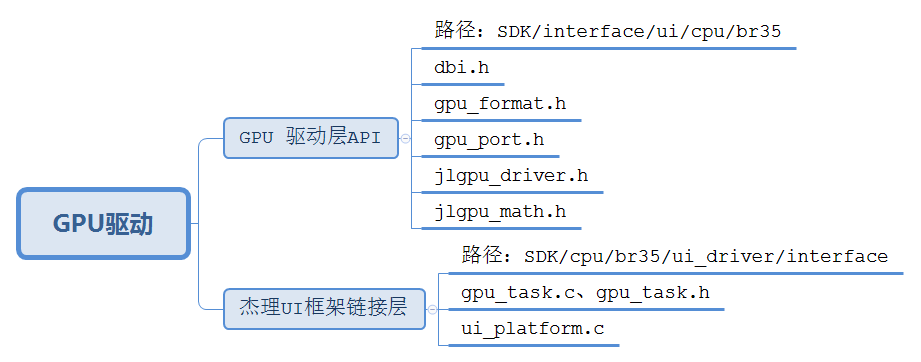
- 707N系列GPU驱动管理可分几层理解,其中”jlgpu_driver.h”为GPU硬件驱动代码,直接驱动GPU寄存器;”gpu_port.h”为GPU任务管理模块,调用GPU硬件驱动,并在其基础上增加GPU任务、GPU任务链、多任务链管理逻辑。应用层代码使用本文件API,方便后续GPU驱动修改时移植;”gpu_task.c, gpu_task.h”为GPU任务链管理模块调度逻辑,作为与UI框架的连接层,可创建GPU os_task 用于调度GPU绘制,与UI框架并行处理绘图任务。
- GPU 硬件相关代码文件为:
GPU变换矩阵计算模块
我们提供了GPU仿射变换矩阵计算模块,API放置于jlgpu_math.h,需注意,这里API目前只提供仿射变换的矩阵计算,暂未支持透视矩阵计算功能。
常用的矩阵计算API有:
| 函数名 | 描述 |
|---|---|
| gpu_matrix_set_identity | 设置矩阵为单位矩阵 |
| gpu_matrix_translate | 设置矩阵平移 |
| gpu_matrix_scale | 设置矩阵缩放 |
| gpu_matrix_rotate | 设置矩阵旋转 |
| ==gpu_matrix_get_boundbox== | 获取方框经矩阵变换后的位置大小 |
矩阵计算
变换矩阵遵从先缩放、后旋转、再平移的计算顺序,但矩阵计算模块是通过左乘的方式实现矩阵效果叠加的,因此在调用API进行矩阵计算时,API调用顺序应为:先平移、后旋转、再缩放。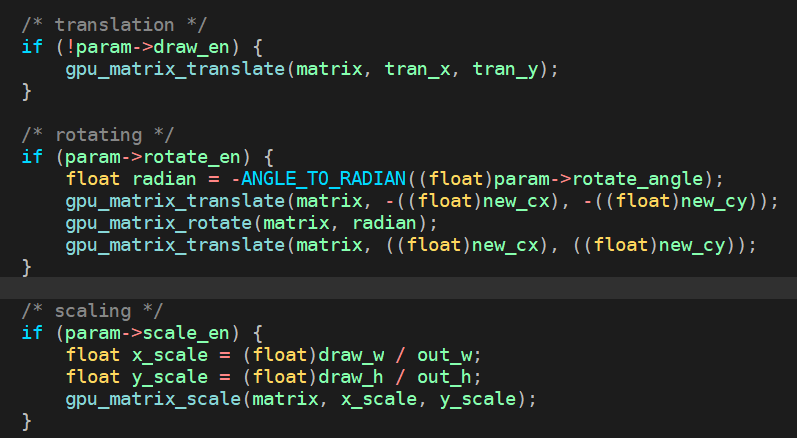
- 矩阵乘法不满足交换律,因此计算的先后顺序会影响计算结果:AB != BA
- 矩阵乘法满足结合率,因此不同的GPU任务可以叠加同一个变换效果:(AB)C = A(BC)
- 变换矩阵都是相对于0坐标点进行计算,可理解为需告诉GPU如何才能将元素移到坐标0点,因此计算平移、缩放、旋转时需有不同的注意点:
- 缩放时,因为元素本身是在坐标0点,因此缩放无需平移,只需配置缩放系数即可;
- 旋转时,需先将旋转中心移到坐标0点,再进行旋转计算,旋转计算完毕后需再将元素顶点移回坐标0点;
- 平移时,可以理解为通过矩阵告诉GPU如何将元素移动到坐标系0点,因此平移参数为负数。
矩阵参数
- 鉴于矩阵参数于一般理解有些区别,可通过将矩阵作用在空间上来帮助理解矩阵计算API参数含义:
- 平移时,平移参数与目标位置相反,将元素平移到(x, y)坐标位置,则需将背景空间往反方向移动(-x, -y),因此平移计算为: gpu_matrix_translate(matrix, -x, -y);
- 旋转时,旋转中心为(cx, cy),旋转角度为angle,需将角度转为弧度,将旋转中心移到世界坐标0点时,移动逻辑与矩阵平移一致,旋转后需将矩阵平移回世界坐标0点位置: { gpu_matrix_translate(matrix, -cx, -cy); gpu_matrix_rotate(matrix, RADIAN(angle)); gpu_matrix_translate(matrix, cx, xy); }
- 缩放时,将元素宽、高都缩小到0.5倍,在空间角度看,是将空间放大2倍: gpu_matrix_scale(matrix, 1/0.5, 1/0.5);
GPU驱动移植
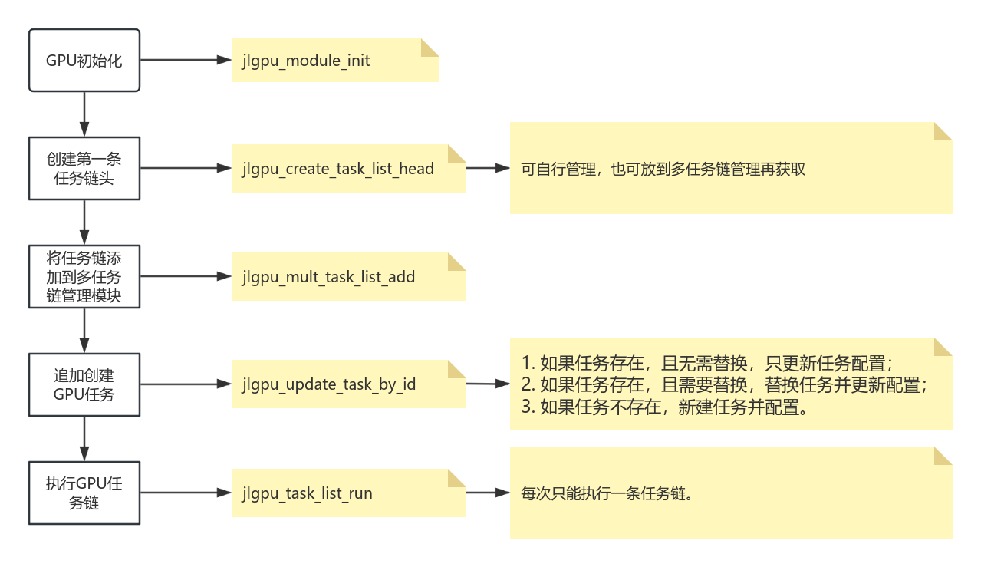
移植GPU驱动几个基本步骤,以下流程运行如果正常,则GPU驱动已能正常运行,之后再调整其它逻辑完善 UI 框架与 GPU 之间的调度逻辑。
- 启动GPU模块:jlgpu_module_init
- 创建GPU任务链:jlgpu_create_task_list_head
- 设置GPU任务链输出格式:jlgpu_set_task_list_out_format
- 添加GPU任务(先用GPU_FILL测试):jlgpu_update_task_by_id
- 设置GPU任务链输出buf和输出区域:jlgpu_set_task_list_out_buf
- 执行GPU任务链:jlgpu_task_list_run
- 确认步骤5设置的buf中得到希望输出的结果,至此GPU模块已运行起来。
- 将输出buf推送到LCD屏幕显示。 若GPU运行正常,则只需完善步骤4,通过UI框架在GPU任务链中创建各功能的GPU任务,待所有任务创建完毕后启动GPU绘制并推屏即可
四、GPU demo示例参考
gpu 的显示demo 可以参考707 watch sdk 里面的gpu_demo示例,里面有完整的ram或者flash 显示图片,缩放、旋转、透视、矩阵运算等demo示例,可以参考调用。
- gpu demo运行配置 使能gpu_demo的宏定义,然后编译代码。
 下载资源
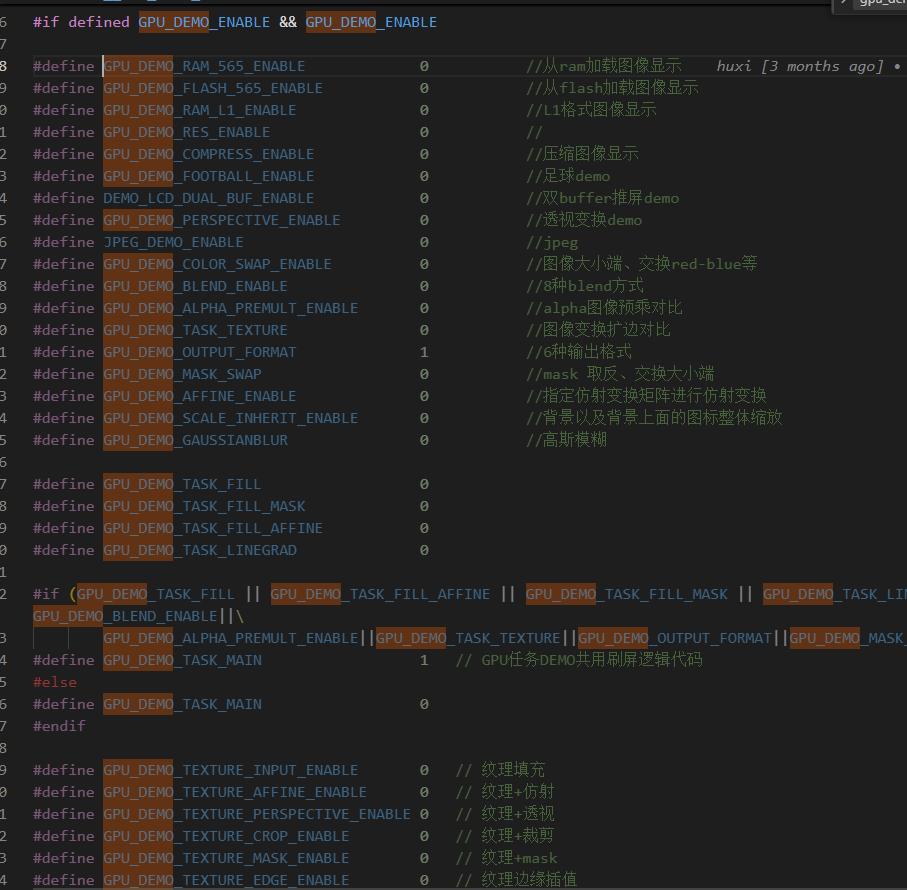
下载资源调用路径下 SDK\cpu\br35\tools\download\watch\download_jlui_demo.bat批处理则可以下载对应的gpu demo资源。 - gpu demo 示例集合 gpu_demo 示例集合的功能配置在gpu_demo.h文件中,里面有对应的gpu 效果示例。
#define GPU_DEMO_RAM_565_ENABLE             0           //从ram加载图像显示
#define GPU_DEMO_FLASH_565_ENABLE           0           //从flash加载图像显示
#define GPU_DEMO_RAM_L1_ENABLE              0           //L1格式图像显示
#define GPU_DEMO_RES_ENABLE                 0           //
#define GPU_DEMO_COMPRESS_ENABLE            0           //压缩图像显示
#define GPU_DEMO_FOOTBALL_ENABLE            0           //足球demo
#define DEMO_LCD_DUAL_BUF_ENABLE            0           //双buffer推屏demo
#define GPU_DEMO_PERSPECTIVE_ENABLE         0           //透视变换demo
#define JPEG_DEMO_ENABLE                    0           //jpeg
#define GPU_DEMO_COLOR_SWAP_ENABLE          0           //图像大小端、交换red-blue等
#define GPU_DEMO_BLEND_ENABLE               0           //8种blend方式
#define GPU_DEMO_ALPHA_PREMULT_ENABLE       0           //alpha图像预乘对比
#define GPU_DEMO_TASK_TEXTURE               0           //图像变换扩边对比
#define GPU_DEMO_OUTPUT_FORMAT              1           //6种输出格式
#define GPU_DEMO_MASK_SWAP                  0           //mask 取反、交换大小端
#define GPU_DEMO_AFFINE_ENABLE              0           //指定仿射变换矩阵进行仿射变换
#define GPU_DEMO_SCALE_INHERIT_ENABLE       0           //背景以及背景上面的图标整体缩放
#define GPU_DEMO_GAUSSIANBLUR               0           //高斯模糊

#define GPU_DEMO_TASK_FILL                  0
#define GPU_DEMO_TASK_FILL_MASK             0
#define GPU_DEMO_TASK_FILL_AFFINE           0
#define GPU_DEMO_TASK_LINEGRAD              0
#define GPU_DEMO_TEXTURE_INPUT_ENABLE       0   // 纹理填充
#define GPU_DEMO_TEXTURE_AFFINE_ENABLE      0   // 纹理+仿射
#define GPU_DEMO_TEXTURE_PERSPECTIVE_ENABLE 0   // 纹理+透视
#define GPU_DEMO_TEXTURE_CROP_ENABLE        0   // 纹理+裁剪
#define GPU_DEMO_TEXTURE_MASK_ENABLE        0   // 纹理+mask
#define GPU_DEMO_TEXTURE_EDGE_ENABLE        0   // 纹理边缘插值
#define GPU_DEMO_DITHER_ENABLE              0   // dither功能
每一个宏对应的是一个gpu的效果demo,可以根据实际的需求参考移植。
This electronic documentation and any attachments are confidential and may be legally privileged or otherwise protected from disclosure. If you are not the intended recipient, please do not disclose the contents to anyone。
Thank you for your cooperation!
解析权归杰理所有!
The analysis right belongs to JieLi Technology Co., Ltd.