多国语言及字库使用指南
📎 原始文档:https://www.kdocs.cn/l/cqDBWu6IfcVu 多国语言及字库使用指南
往期文档:
编写目的 本文档会针对杰理平台的文字显示进行一些必要的讲解,提供一些常用的操作demo以及对一些常见问题进行解答,帮助用户快速上手。
*本文档的演示操作均是基于701n_watch_release_v2.0.1进行,对于701n_watch_release_v2.0.0版本和701n_watch_release_v1.0.4版本来说也是大同小异,至于在AC695N_watch_sdk_release_3.1.5存在差异的部分会在相关地方特意指出。文字控件及其相关接口介绍
(一)文字控件
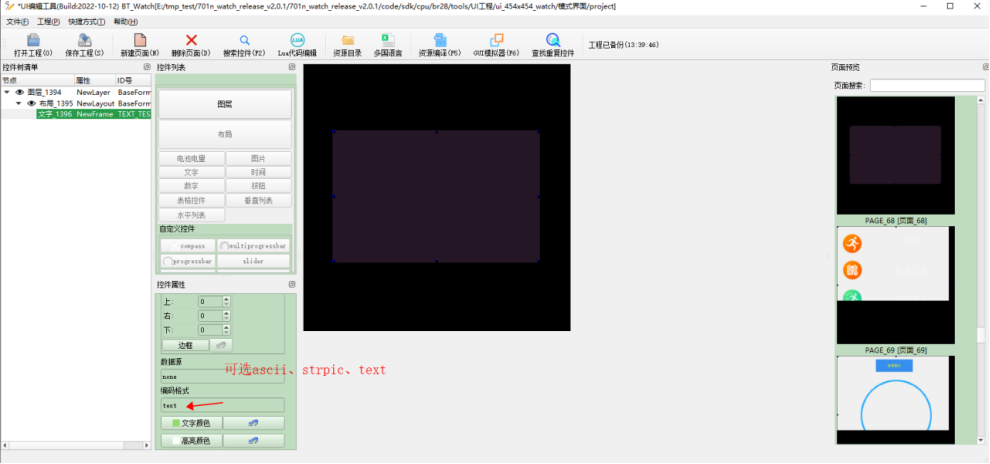 文字控件在ui工程中如上图所示,其中文字控件的编码格式主要有三种,分别是ascii、strpic、和text,其中ascii主要用于显示ascii码的场合,本质上是使用了内置ascii字库;strpic对应多国语言表,需要在文字列表中勾选相应文字进行显示,一般用于内容比较固定的场合,如菜单列表中的“锻炼”、“锻炼记录”等字样;text对应字库显示,不需要勾选多国语言表,而是直接通过程序设置需要显示内容,依赖于相应的字库文件,多用于非固定内容场合,如消息显示,歌词歌名显示等。
(二)文字控件相关接口
1. 显示类接口
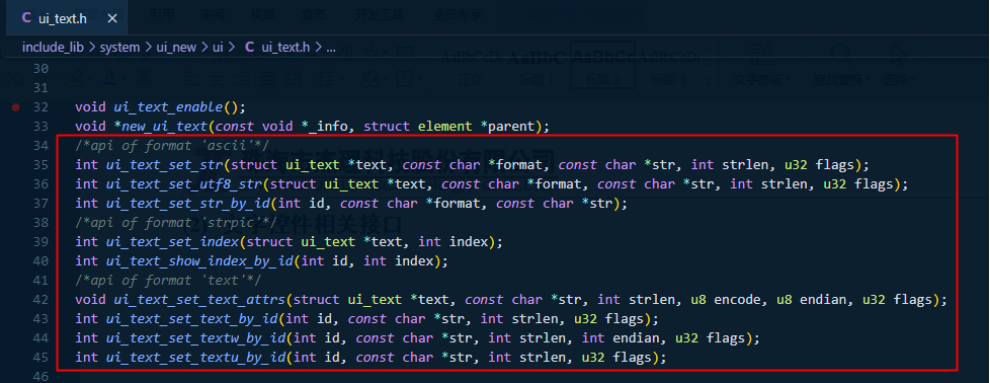 文字控件的相关接口可以在ui_text.h中找到,本文档主要讲解中几个常用的接口,如下所示:
/* ansi格式接口:*/
/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_str 文本控件显示ANSI编码字符串
 *
 * @param text 文本控件句柄
 * @param format 文本编码格式
 * @param str 文本字符串
 * @param strlen 文本字符串长度
 * @param flags 显示标志
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_str(struct ui_text *text, const char *format, const char *str, int strlen, u32 flags);

/* Example:*/
ui_text_set_str(text, "ascii", "0123", strlen("0123"), FONT_DEFAULT);


/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_utf8_str 设置文本控件显示UTF-8编码字符串
 *
 * @param text 文本控件句柄
 * @param format 文本编码格式
 * @param str 文本字符串
 * @param strlen 文本字符串长度
 * @param flags 显示标志
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_utf8_str(struct ui_text *text, const char *format, const char *str, int strlen, u32 flags);

/* Example:*/
u8 *name = bt_list_get_name_by_number(index);
ui_text_set_utf8_str(text, "text", name, strlen(name), FONT_DEFAULT);


/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_str_by_id 设置文本控件显示字符串(带redraw)
 *
 * @param id 文本控件ID
 * @param format 文本编码格式
 * @param str 文本字符串指针
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_str_by_id(int id, const char *format, const char *str);

/* Example:*/
ui_text_set_str_by_id(TEXT1, "ascii", "0123");


/* strpic格式接口:*/
/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_index 设置文本控件显示的文本索引
 *
 * @param text 文本控件句柄
 * @param index 文本在“文字列表”中的索引
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_index(struct ui_text *text, int index);

/* Example:*/
ui_text_set_index(text, 0);


/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_show_index_by_id 设置文本控件显示的文本索引(带redraw)
 *
 * @param id 文本控件ID
 * @param index 文本在“文字列表”中的索引
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_show_index_by_id(int id, int index);

/* Example:*/
ui_text_show_index_by_id(TEXT1, 3);


/* text格式接口:*/
/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_text_attrs 设置文本控件属性
 *
 * @param text 文本控件句柄
 * @param str 文本字符串指针
 * @param strlen 文本字符串长度
 * @param encode 文本字符串编码格式
 * @param endian 文本字符串大、小端
 * @param flags 显示标志
 */
/* ------------------------------------------------------------------------------------*/
void ui_text_set_text_attrs(struct ui_text *text, const char *str, int strlen, u8 encode, u8 endian, u32 flags);

/* Example:*/
ui_text_set_text_attrs(text, “0123”, strlen(“0123”), FONT_ENCODE_UTF8, 0, FONT_DEFAULT);


/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_text_by_id 设置指定ID的文本控件显示ANSI编码字符串(带redraw)
 *
 * @param id 文本控件ID
 * @param str 字符串指针
 * @param strlen 字符串长度
 * @param flags 显示标志
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_text_by_id(int id, const char *str, int strlen, u32 flags);

/* Example:*/
ui_text_set_text_by_id(TEXT1, “0123”, strlen(“0123”),FONT_DEFAULT);


/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_textw_by_id 设置指定ID的文本控件显示UNICODE编码字符串(带redraw)
 *
 * @param id 文本控件ID
 * @param str 宽字节字符串
 * @param strlen 字符串长度
 * @param endian 存储格式(大端、小端)
 * @param flags 显示标志
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_textw_by_id(int id, const char *str, int strlen, int endian, u32 flags);

/* Example:*/
ui_text_set_textw_by_id(TEXT1, “0123”, strlen(“0123”),0,FONT_DEFAULT);


/* ------------------------------------------------------------------------------------*/
/**
 * @brief ui_text_set_textu_by_id 设置指定ID的文本控件显示UTF8编码字符串(带redraw)
 *
 * @param id 文本控件ID
 * @param str UTF8编码字符串
 * @param strlen 字符串长度
 * @param flags 显示标志
 *
 * @return 0 正常,-22 控件不存在
 */
/* ------------------------------------------------------------------------------------*/
int ui_text_set_textu_by_id(int id, const char *str, int strlen, u32 flags);

/* Example:*/
ui_text_set_textw_by_id(TEXT1, “0123”, strlen(“0123”),FONT_DEFAULT);
其中需要注意的主要有两点:
一是上述中带by_id后缀的接口均带重绘,故不能在onchange事件中直接调用,否则会触发刷新,刷新又触发onchange,从而在此触发onchange中的redraw,陷入死循环。建议在onchange中调用句柄接口去对文字控件的属性进行配置,在ontouch或onkey中根据需要调用by_id接口;二是上述接口中的字符串必须是静态的,否则在显示过程中被释放掉会引发其他问题。其中最常用的接口是ui_text_set_text_attrs,因为这个接口基本上能实现其他字库接口的功能。
2. 语言切换接口
/* 多国语言设置/获取接口:*/
/**
 * @brief 设置多国语言表语言ID
 * @attention 该接口建议在ui线程中调用,防止出现资源没打开
 * @param language 语言ID
 * @return int 返回改语言ID,表示切换成功
 */
int ui_language_set(int language);

/* Example:*/
ui_language_set(Chinese_Simplified);


/**
 * @brief 获取当前多国语言表语言ID
 *
 * @return int 返回当前多国语言表语言ID
 */
int ui_language_get();

/* Example:*/
int ret = ui_language_get();

字库设置/获取接口:
/**
 * @brief 设置字库语言ID
 *
 * @param language 语言ID
 */
void font_lang_set(int language);

/* Example:*/
font_lang_set(Chinese_Simplified);
/**
 * @brief 获取当前字库语言ID
 *
 * @return int 返回当前字库语言ID
 */
int font_lang_get();

/* Example:*/
int ret = font_lang_get();
需要注意的是,701系列的sdk从102版本开始已经将字库与多国语言表的设置和获取接口分开,故两者不再相关联,而695系列的sdk仍然是通过ui_language_set()和ui_language_get()进行字库和多国语言表的统一管理,切换多国语言,字库也会跟着切换。
3. 转换类接口
/* --------------------------------------------------------------------------*/
/**
 * @brief UFT8 转换 Unicode
 *
 * @param utf8_buf UTF8编码的字符串
 * @param pUniBuf short 类型Unicode字符串
 * @param utf8_len utf8数据长度
 *
 * @return  得到的unicode码大小
 */
/* ----------------------------------------------------------------------------*/
int UTF82Unicode(const char *utf8_buf, u16 *pUniBuf, int utf8_len);

/* --------------------------------------------------------------------------*/
/**
 * @brief  Unicode 转 UTF8
 *
 *
 * @param utf8_buf UTF8编码的字符串
 * @param pUniBuf short 类型Unicode字符串
 * @param uni_len unicode数据长度
 *
 * @return  得到的UTF8码大小
 */
/* ----------------------------------------------------------------------------*/
int Unicode2UTF8(char *utf8_buf, u16 *pUniBuf, int uni_len);

/* --------------------------------------------------------------------------*/
/**
 * @brief 检查是否UTF8 码格式
 *
 * @param str 数据buff
 * @param length 数据buff长度
 *
 * @return 1:是UTF8 0:不是
 */
/* ----------------------------------------------------------------------------*/
bool utf8_check(const char *str, int length);
4. 滚动速度控制
/* ------------------------------------------------------------------------------------*/
/**
 * @brief text_set_strpic_scroll_interval 设置strpic文本滚动时间间隔
 *
 * @param ms 默认250ms
 */
/* ------------------------------------------------------------------------------------*/
void text_set_strpic_scroll_interval(u16 ms);

/* Example:*/
text_set_strpic_scroll_interval(500);

/* ------------------------------------------------------------------------------------*/
/**
 * @brief text_set_font_scroll_interval 设置字库文本滚动间隔
 *
 * @param ms 默认1000ms
 */
/* ------------------------------------------------------------------------------------*/
void text_set_font_scroll_interval(u16 ms);

/* Example:*/
text_set_font_scroll_interval(2000);
调整文字滚动速度的方法有两种,一种是固定时间间隔,修改滚动步进,另一种则是固定滚动步进,修改时间间隔。以上两个接口针对的是后一种方式。
- 多国语言表以及字库的使用
(一)显示多国语言表
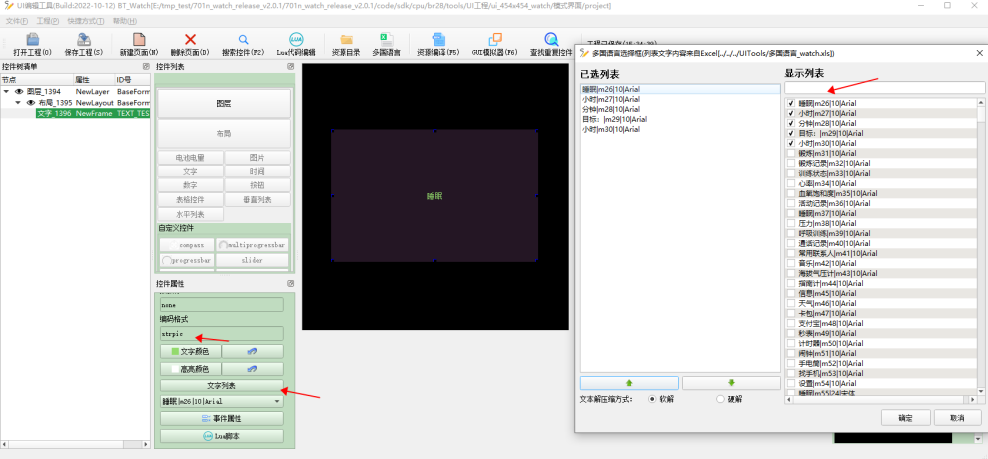 多国语言表的显示步骤非常简单,在文字控件的编码格式中设置strpic后,点击文字列表,勾选上需要显示的字符串即可。默认显示index为0的字符串,切换到其他字符串显示则可以使用第二节所提到的接口。
对于新增,删除,或者修改显示列表中的内容,用户可以在多国语言_watch.xls中进行增删改,以及一些其他语言包括阿拉伯语、印地语等,用户需要根据自身需求将用到的语言字符自行翻译到excel表中。
添加完所需的多国语言字符串后,点击资源编译,资源编辑工具会将多国语言表的字符串资源打包到.str文件中,最终下载到外置flash中,显示时则会打开相应资源进行显示。
其中有以下几点需要注意:
对于excel表中一些纯数字的字符串,需要设置成文本类型,否则数字0可能会被省略掉,如下图所示:
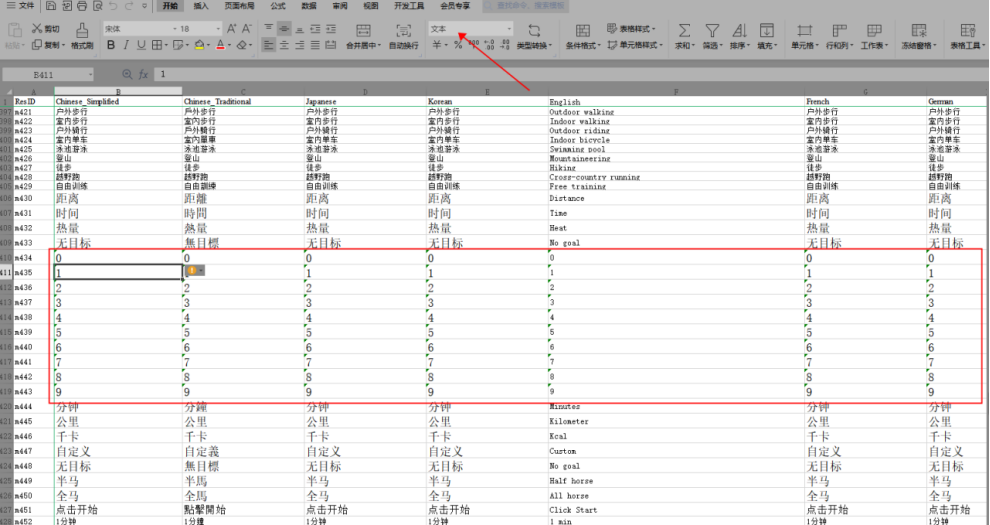
excel表的内容决定了多国语言表显示的内容,这是因为资源编译直接读取的就是excel表的字模,故多国语言表的字体样式,字号以及字符间间隙等均可通过修改excel表的方式进行调整。
在10x版本的sdk中,ui工程的资源路径下会有使用到的多国语言表字符串的预览图,如下图中的m25.png:
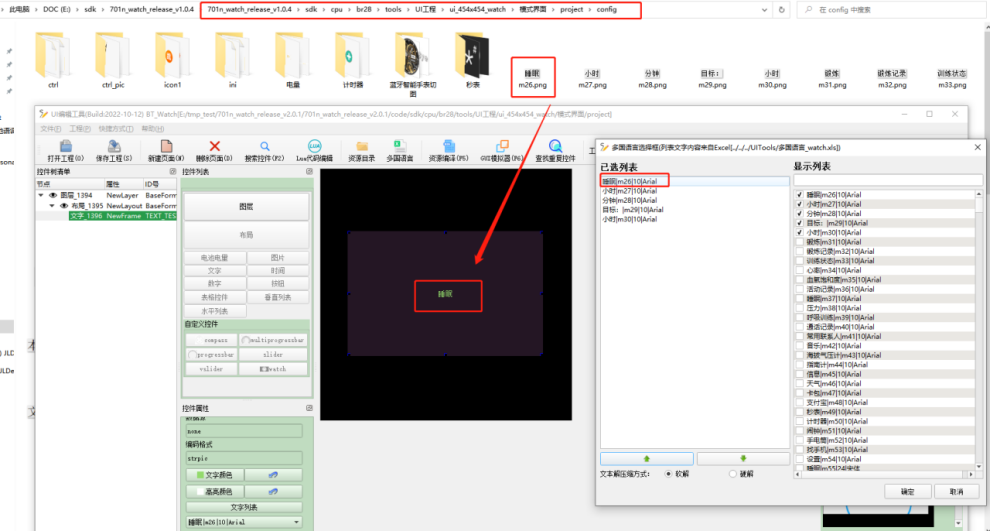 多国语言表的预览图的作用只是在ui编辑工具中提供可视化的方式,以便于ui工程的搭建和开发,而不是最终下载到外置flash中的字符串资源。
若在调用ui_language_set切换语言时出现卡死,具体可能表现为一段时间内没打印,最后出现看门狗超时,也可能表现为断言,此时可以在ui_language_set前调用select_strfile(0),如下所示:
/* 在设置语言前调用select_strfile */
extern void select_strfile(u8 index);
select_strfile(0);
ui_language_set(language);
(二)切换多国语言表
切换多国语言表,这里以英语为例,需要将ui资源生成工具中用到的语言给勾选上,如下图所示: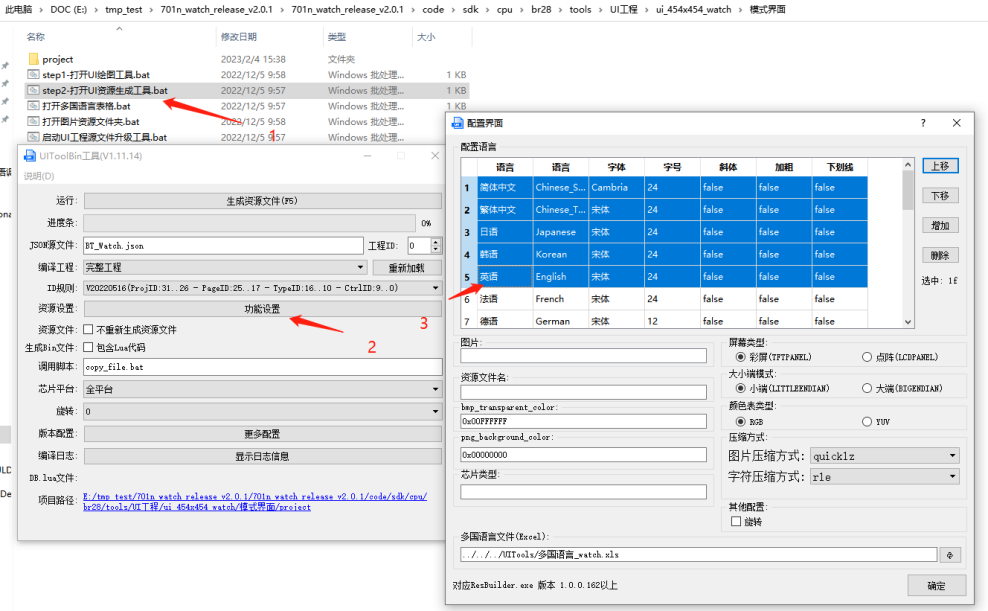 若除了模式界面外的其他ui工程也用到了相应语言,则需要在相应目录下也勾选上,同时还需保证资源生成工具中的语言的序号,用到的语言ID,以及excel表中对应的列序号一致,这里以英语为例进行演示:
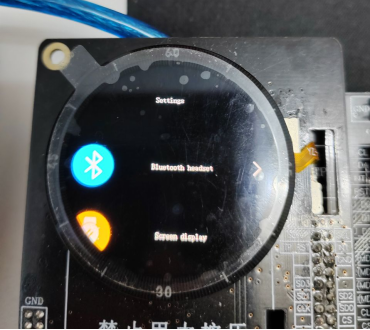
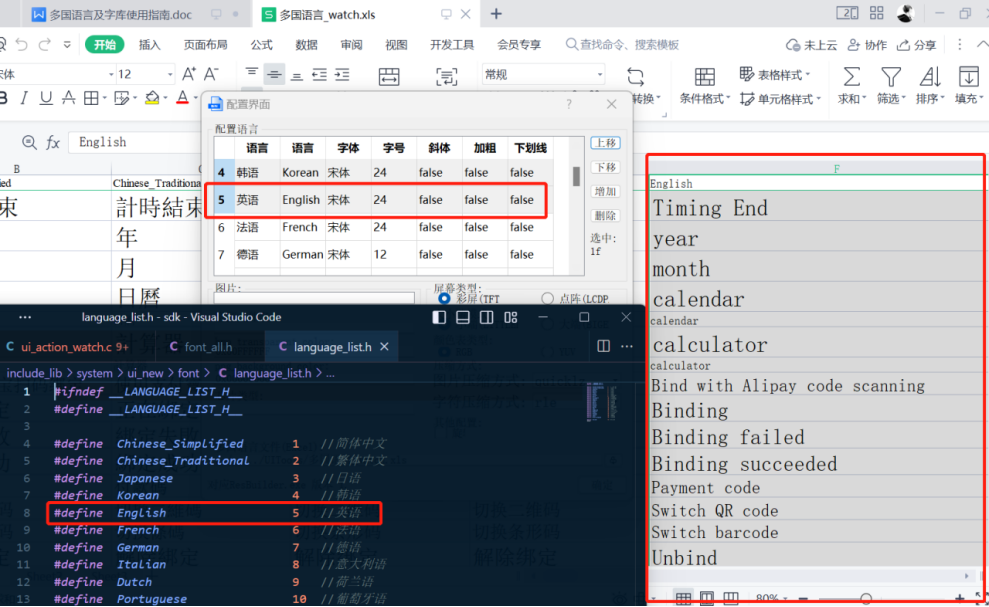 如上图所示,需要保证language_list.h中English对应的数字5,与ui资源生成工具中的英语对应的序号5,以及excel表中对应的第5列一致,才能保证打开正确的字符串资源。接下来,只需要在ui线程中合适的地方调用ui_language_set(English),即可切换到多国语言的英语,也可参考公版中ui_action_set.c的用法,效果展现如下:
(三)添加多国语言表
下面以添加印地语为例进行演示,如下图所示: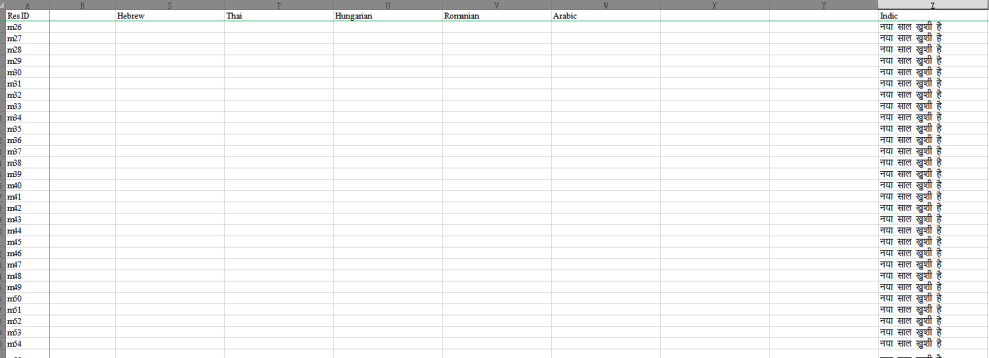 由于font_all.h中,印地语对应的是25,故在excel表中需要将其添加到第25列,这里为了方便演示,全部采用了相同的印地语字符串,用户则需要根据需求进行翻译。
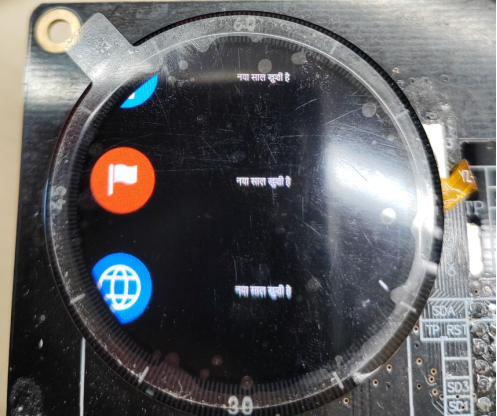
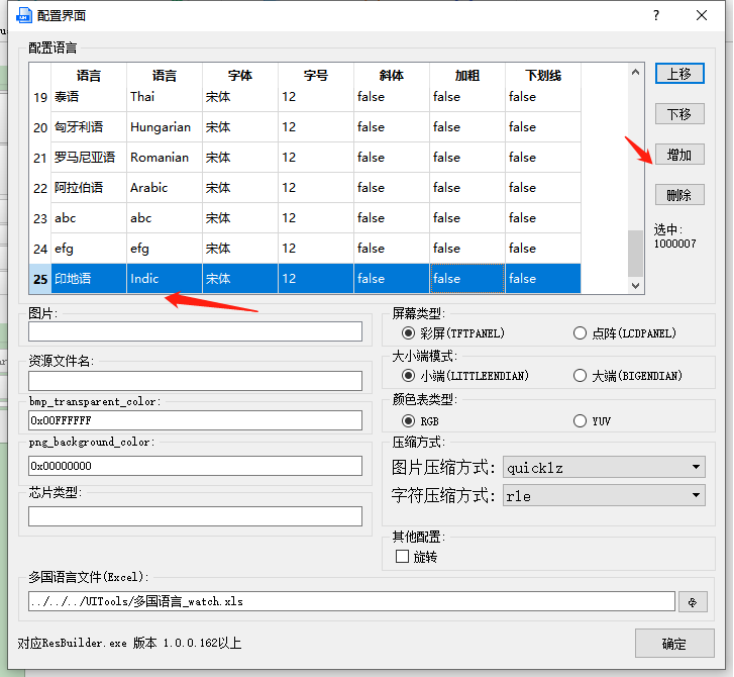 同样,在资源生产工具中需要将印地语添加到序号为25的行中,然后在ui线程调用ui_language_set(Indic)即可看到现象,如下图所示:
(四)多国语言表省空间方案
修改text_type
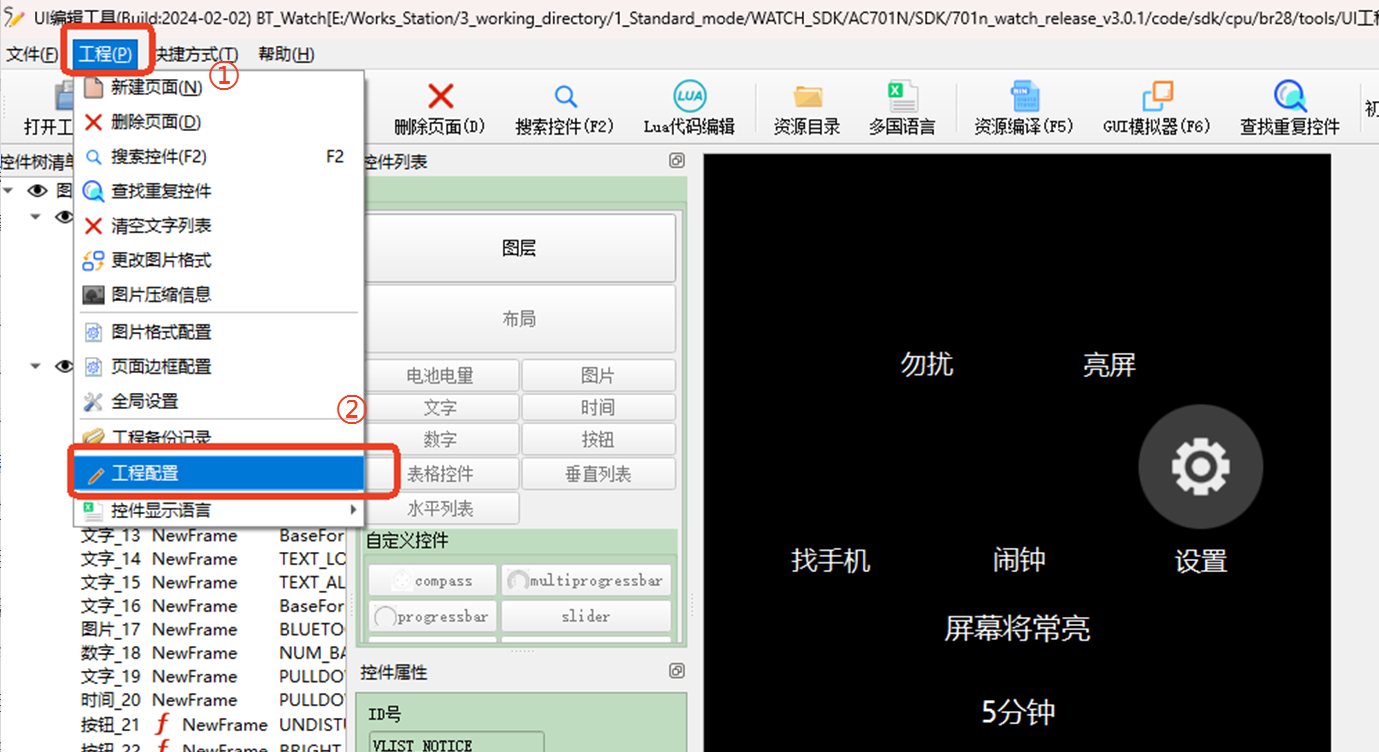
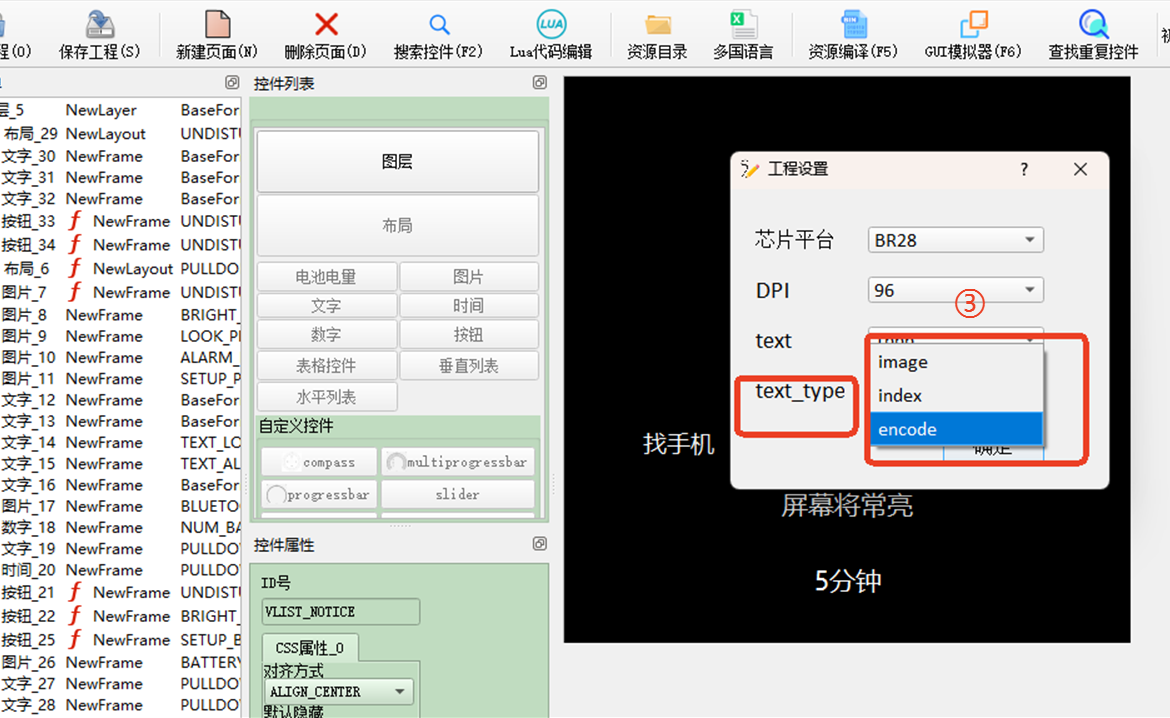 在ui工程中,依次 “工程”->“工程配置”->选择text_type,有几种方案可以选择:
image:将多国语言表词条以整张图片的形式进行显示,需要将整个词条保存为整张图片,同时也是旧版sdk一直以来默认使用的方式。该模式下,缺点是占空间,比如词条“你好”和“好啊”两个词条都会分别占用一张图片,假设这两个词条字号、字体均一样的情况下,“好”这个字符其实是重复占用的,优点是速度快,因为只有一张图片,只需要创建一个imb任务;
index:将多国语言表词条尽可能按字符拆分开,并将不同字符进行拼接显示。比如词条“你好”和“好啊”两个词条,假设这两个词条字号、字体均一样的情况下,两个词条就会分别拆成“你”“好”“啊”三张图片,那么显示的“你好”时候会将“你”“好”拼接起来,显示“好啊”的时候会把“好”“啊”拼接起来;若上述两个词条字体或者字号是不一样的情况下,尽管“好”字在两个词条里重复,但还是会被识别为不同的资源;该模式下,优点是资源占用少了,缺点是速度慢,原本一个imb任务会被拆分成多个,几乎是一个字符一个任务,时间复杂度会增加,可能会造成卡顿,在英文一些单词比较长的情况下可能会特别明显;另外对于一些特殊语言如阿拉伯语、印地语、希伯来语等拼接复杂的,工具会默认按照image的方式进行处理,不会按字符拆分为单张图片;
encode:将多国语言表使用字库进行显示。几乎不会额外占用图片资源,但会保存多国语言表中词条的unicode编码,该模式下,几乎是最省空间的,但跟字库一样,同种语言下不支持多种字号和多种字体,即便支持,也需要不同字号的点阵字库文件,依然会导致需要多一份资源。
以上三种方式中,image和index都是会根据excel表里面的内容去进行图片采集的,也就是说词条的字号或者字体不一样,都会重新采集,比如16字号的“好”跟18字号的“好”是两份资源,这意味着上述两种方式都允许用户有不同的字号跟不同的字体。从资源压缩率来说,image < index,但速度上一般是image > index。需要注意的是,text_type目前是全局配置的,暂时不支持针对单个页面进行配置,从资源管理上来说也会导致情况变得复杂。修改压缩方式
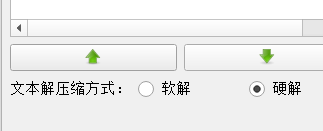 硬解压缩率低,具体表现为更占用空间,但解压速度快;软解压缩率高,空间占用率会低一些,但速度慢一些,一般来说文字出现撕裂可以考虑部分硬解,不建议全部改硬解,若全部改为硬解会导致资源过大,其他情况下则可以修改为软解,支持局部配置。默认1bpp情况下不压缩,故无法选择软件或者硬解。
(五)字库的添加及切换(内码字库)
1. 背景说明
显示相应的语言,需要依赖于相关的字库文件(.PIX、.TAB等),这些文件本质上为字模和转换表,695系列与701系列通用,除此之外还需要相关库文件,其中701系列用到的是font_new.a,而695系列用到的是font.a。
而公版默认使用的字库是内码字库,该字库的特点是需要用到.TAB文件进行unicode码到内码的转换。其中内码字库底层处理流程如下: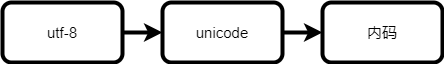 该字库下,底层只有一个内码字库,目的是为了节省资源空间。同时为了兼容其他编码,其他编码最终均需要转换为内码,才能够查找对应字模。比如输入的字符串是utf-8编码,底层会将utf-8编码转换为unicode编码,unicode编码再转换为内码并查表;如果输入的是unicode,那么底层会将unicode编码转换为内码,再去查表;如果输入的是内码,那即可直接查表。就是通过这种方式,使得内码字库能够兼容utf-8编码,unicode编码和内码,因此使用ui_text_set_text_attrs接口时,可选参数有FONT_ENCODE_UTF8、FONT_ENCODE_UNICODE和FONT_ENCODE_ANSI,以及第二章第二节的显示接口中,可以使用ansi接口。同时只有一份字库资源。
此外,杰理字库的解析流程是根据id进行的,如font_lang_set(Arabic)后,底层则会走阿拉伯语处理分支,去解析阿拉伯语,一般情况下,右对齐语言如阿拉伯语和希伯来语,均可以使用id UnicodeMixLeftword和其对应的id(如显示阿拉伯语则用Arabic,希伯来语则使用Hebrew)进行显示,而左对齐语言均可使用id UnicodeMixRightword 和其对应的id进行显示。其中UnicodeMixLeftword和UnicodeMixRightword是两个非常强大的id,分别按照从右向左的规则进行混合显示和按照从左向右的规则进行混合显示,绝大部分情况下用户可以仅使用这两个id去进行语言设置,以覆盖所有特殊语言。
需要注意的是,language_list.h中的语言id是不允许修改的!!!
/* language_list.h */
#ifndef __LANGUAGE_LIST_H__
#define __LANGUAGE_LIST_H__

#define  Chinese_Simplified       1   //简体中文
#define  Chinese_Traditional      2   //繁体中文
#define  Japanese                 3   //日语
#define  Korean                   4   //韩语
#define  English                  5   //英语
#define  French                   6   //法语
#define  German                   7   //德语
#define  Italian                  8   //意大利语
#define  Dutch                    9   //荷兰语
#define  Portuguese               10  //葡萄牙语
#define  Spanish                  11  //西班牙语
#define  Swedish                  12  //瑞典语
#define  Czech                    13  //捷克语
#define  Danish                   14  //丹麦语
#define  Polish                   15  //波兰语
#define  Russian                  16  //俄语
#define  Turkey                   17  //土耳其语
#define  Hebrew                   18  //希伯来语
#define  Thai                     19  //泰语
#define  Hungarian                20  //匈牙利语
#define  Romanian                 21  //罗马尼亚语
#define  Arabic                   22  //阿拉伯语
#define  Vietnam                  23  //越南语
#define  Tibetan                  24  //藏文
#define  Indic                    25  //印地语
#define  Myanmar                  26  //缅甸语
#define  Bengali                  27  //孟加拉语
#define  Khmer                    28  //高棉语

#define  MixAllLanguage           60  //混合语言
#define  UnicodeMixRightword      61  //Unicode正向混合
#define  UnicodeMixLeftword       62  //Unicode反向混合
#define  Unicode                  63  //Unicode
#endif
具体原因为字库处理逻辑均在font_new.a中,该.a文件是提前编译出来的静态库,编译时预处理器以及根据当时编译时的language_list.h中的宏,也就是id进行逐一替换,如Arabic为22,那么只有当id为22时,才会执行阿拉伯语的解析流程,这意味着解析语言的id在编译出font_new.a的时候已经被固定下来了,与编译出font_new.a时的language_list.h有关,此时用户若把language_list.h中的Arabic改为10,再font_lang_set(Arabic),是无法切换到阿拉伯语解析流程的。故language_list.h需要跟公版保持一致。
此外,701从公版sdk102开始,多国语言表id跟字库id已经实现解耦,那么如果多国语言表有更改顺序的需求改怎么办呢?可以使用另一套id去管理,而字库保持language_list.h的顺序不变,如下:
/* strpic_language_list.h,名字用户可自行修改 */
#ifndef __STRPIC_LANGUAGE_LIST_H__
#define __STRPIC_LANGUAGE_LIST_H__

/* id顺序用户可自行调整 */
#define  STRPIC_Chinese_Simplified       1   //简体中文
#define  STRPIC_Chinese_Traditional      2   //繁体中文
#define  STRPIC_Korean                   3   //韩语
#define  STRPIC_English                  4   //英语
#define  STRPIC_Japanese                 5   //日语
#define  STRPIC_French                   6   //法语
#define  STRPIC_German                   7   //德语
#define  STRPIC_Italian                  8   //意大利语
#define  STRPIC_Dutch                    9   //荷兰语
#define  STRPIC_Arabic                   10  //阿拉伯语
#define  STRPIC_Portuguese               11  //葡萄牙语
#define  STRPIC_Spanish                  12  //西班牙语
#define  STRPIC_Swedish                  13  //瑞典语
#define  STRPIC_Czech                    14  //捷克语
#define  STRPIC_Danish                   15  //丹麦语
#define  STRPIC_Polish                   16  //波兰语
#define  STRPIC_Russian                  17  //俄语
#define  STRPIC_Turkey                   18  //土耳其语
#define  STRPIC_Hebrew                   19  //希伯来语
#define  STRPIC_Thai                     20  //泰语
#define  STRPIC_Hungarian                21  //匈牙利语
#define  STRPIC_Romanian                 22  //罗马尼亚语
#define  STRPIC_Vietnam                  23  //越南语
#define  STRPIC_Tibetan                  24  //藏文
#define  STRPIC_Indic                    25  //印地语
#define  STRPIC_Myanmar                  26  //缅甸语
#define  STRPIC_Bengali                  27  //孟加拉语
#define  STRPIC_Khmer                    28  //高棉语
#endif
那么在切换为阿拉伯语时,一般需要将多国语言表和字库同时切换到阿拉伯语id,此时只需要按照以下方式调用即可:
ui_language_set(STRPIC_Arabic); /* 多国语言表切换到阿拉伯语 */
font_lang_set(Arabic); /* 字库切换到阿拉伯语 */
2. 具体步骤
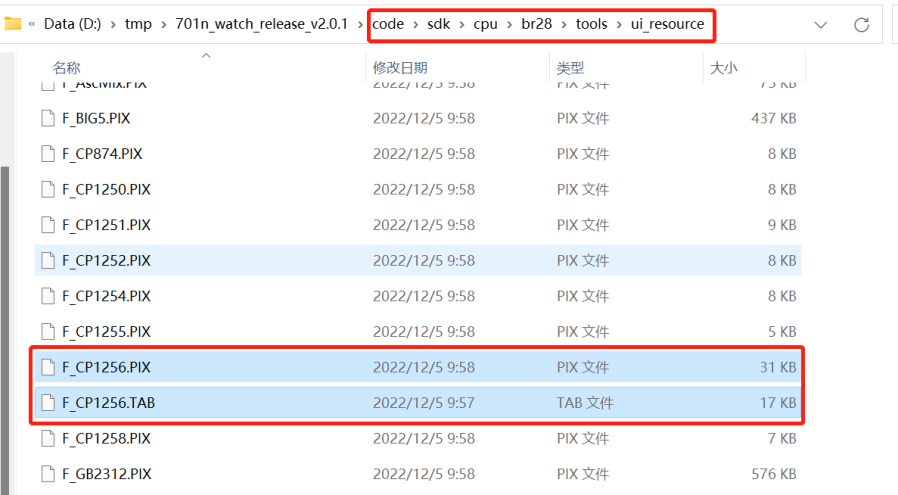
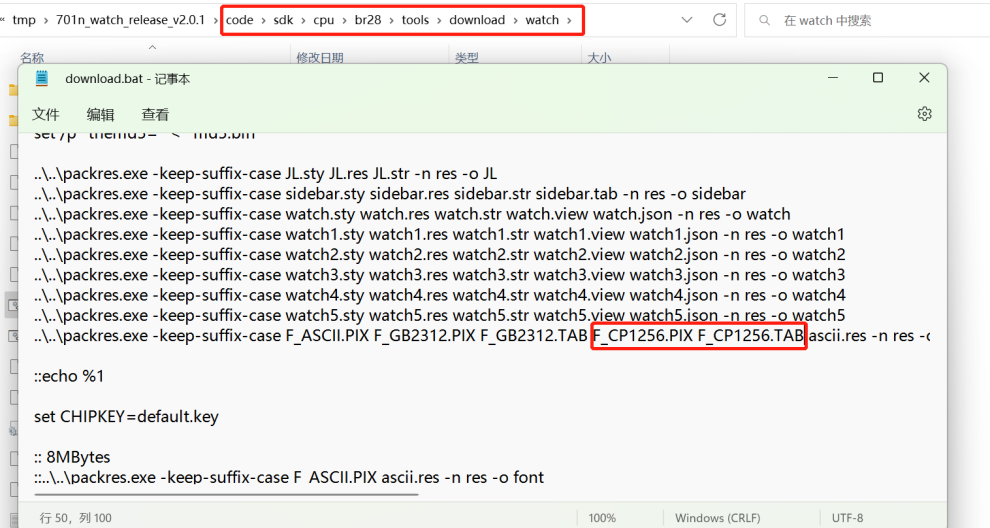
字库文件需要添加到ui_resource路径下,同时在批处理中添加相应文件名,这里以阿拉伯语为例,具体步骤如下:
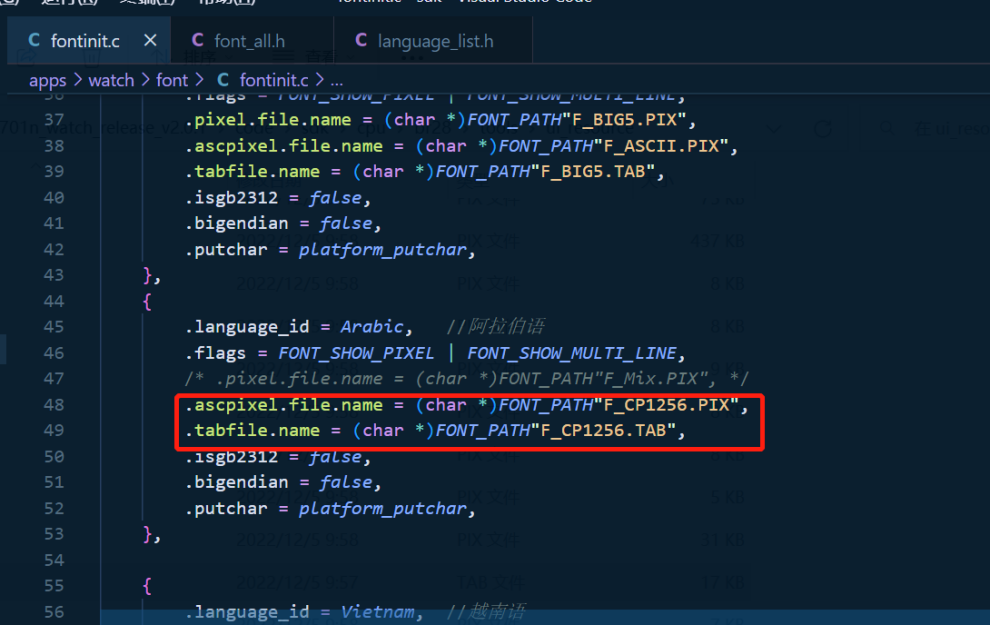
打开fontinit.c,找到阿拉伯语的ID,可以看到阿拉伯语用到了F_CP1256.PIX和F_CP1256.TAB文件,如下图所示;
在ui_resource路径下添加F_CP1256.PIX和F_CP1256.TAB文件,如下图所示:
在download.bat中添加相关文件名,如下图所示:
至于相关.PIX文件和.TAB文件,用户通过font_tool自行提取,提取的教程将会在下面章节进行讲解,也可以在701n_watch_release_v2.0.1\code\sdk\cpu\br28\tools\UI工程\字库文件路径下找到sdk提供好的字库文件,如下图所示: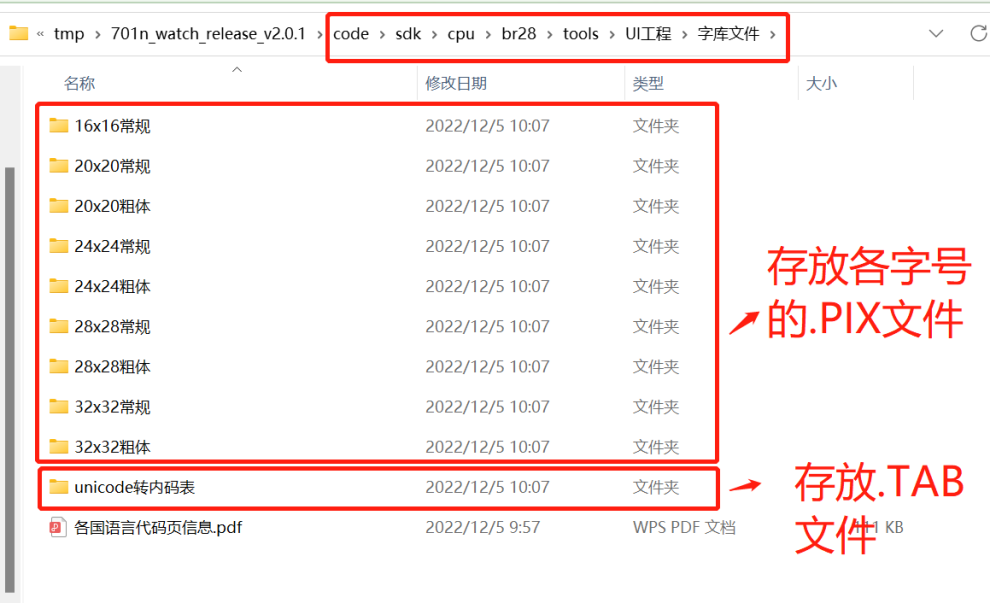
- 切换到相应字库,其中用户可以自行在ui工程中添加文字控件,也可以直接在公版上app_common.c中将字库测试页面PAGE_68添加进卡片,并且在ui_action_watch.c中找到相应控件的onchange事件进行显示实验,如下图所示:
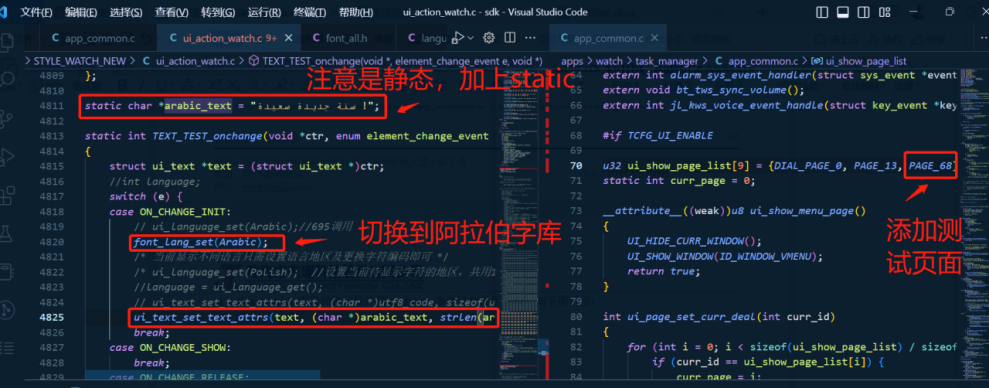
/* 字库显示例程 */
static char *arabic_text = "سنة جديدة سعيدة !";

static int TEXT_TEST_onchange(void *ctr, enum element_change_event e, void *arg)
{
    struct ui_text *text = (struct ui_text *)ctr;
    switch (e) {
    case ON_CHANGE_INIT:
        // ui_language_set(Arabic);//695调用
        font_lang_set(Arabic);
        ui_text_set_text_attrs(text, (char *)arabic_text, strlen(arabic_text), FONT_ENCODE_UTF8, 0, FONT_DEFAULT);
        break;
    case ON_CHANGE_SHOW:
        break;
    case ON_CHANGE_RELEASE:
        break;
    default:
        return FALSE;
    }
    return FALSE;
}


REGISTER_UI_EVENT_HANDLER(TEXT_TEST)
.onchange = TEXT_TEST_onchange,
 .onkey = NULL,
  .ontouch = NULL,
};
完成上述步骤后,即可看到设定的阿拉伯语字符串被显示出来了,如下图所示: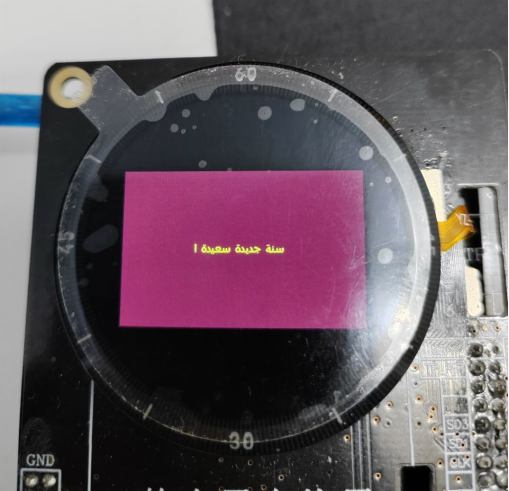
(六)字库的添加与切换(unicode字库)
1. 背景说明
unicode字库底层处理流程与内码字库比起来,少了转换为内码的步骤,故实际上不兼容内码(若需要兼容内码,建议构建内码转utf-8表,传入内码时提前把内码转换为utf-8)只有utf-8到unicode编码的转换,到unicode编码后直接查表,因此使用ui_text_set_text_attrs接口时,可选参数只有FONT_ENCODE_UTF8和FONT_ENCODE_UNICODE,以及第二章第二节的显示接口中,不可以使用ansi接口,否则将无法显示。结合当前工具来说,杰理unicode字库相比内码字库的优势是,支持灵活裁剪,每个代码页需裁剪的编码范围可控。同样,unicode字库跟内码字库一样,是根据id去进行解析的,显示某种语言前需要font_lang_set(id);为对应语言,其中id切换流程跟内码字库完全一致。
2. 具体步骤
unicode字库的添加与非unicode字库的添加流程基本相同,但用到的.PIX文件有所差别,故需要做相应修改,并打开unicode字库开关,具体步骤如下:
修改fontinit.c文件,将所有.PIX文件改为FONT_PATH“F_UNIC_ALL.PIX",以及把.isgb2312改为false,如下图所示:
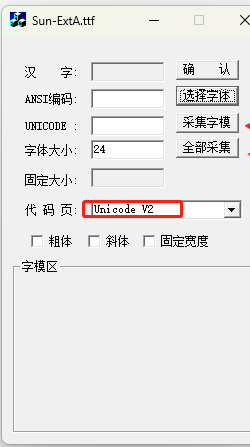
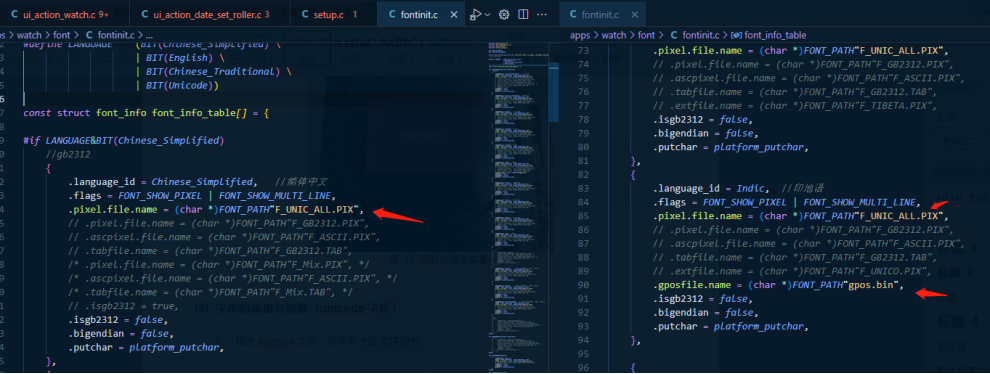 特别的,印地语要加上.gposfile.name = (char *)FONT_PATH"gpos.bin",如果混合id(UnicodeMixRightword、UnicodeMixLeftword)也要求显示印地语,则同样需要加上。其中,不管是F_UNIC_ALL.PIX还是F_UNIC.PIX都无所谓,只是个名字罢了,用户可以自行修改,但为了统一称呼,下文均使用“F_UNIC_ALL.PIX”进行说明。只要保证该PIX文件是字模提取工具使用Unicode v2模式提取出来的即可。如下:
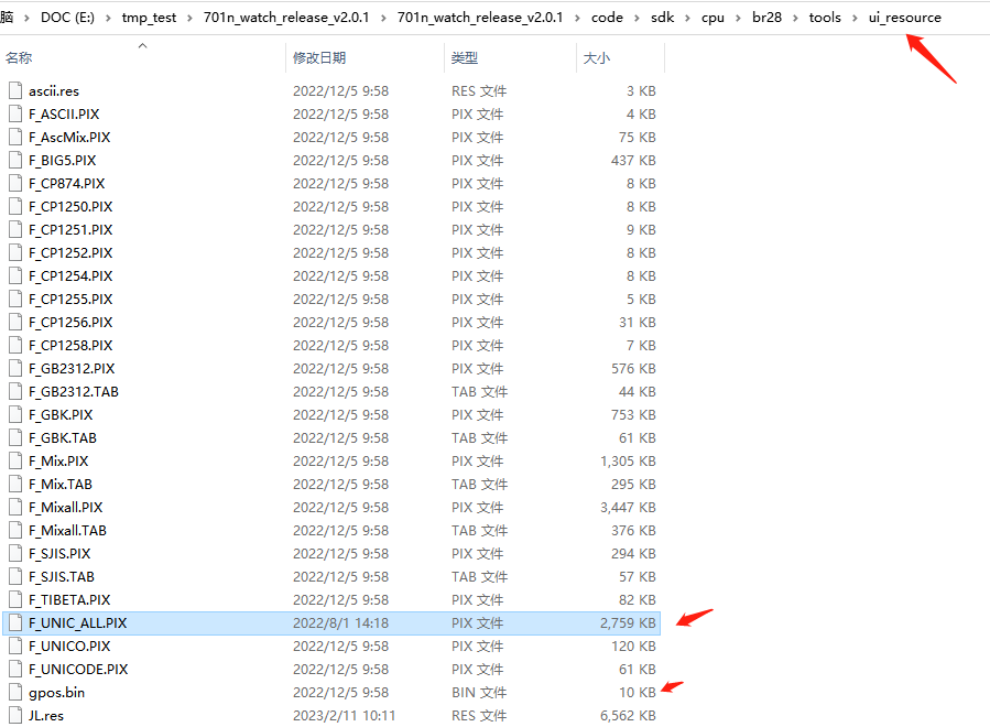
在ui_resource路径下添加F_UNIC_ALL.PIX和gpos.bin(根据是否使用印地语进行添加),如下图所示:
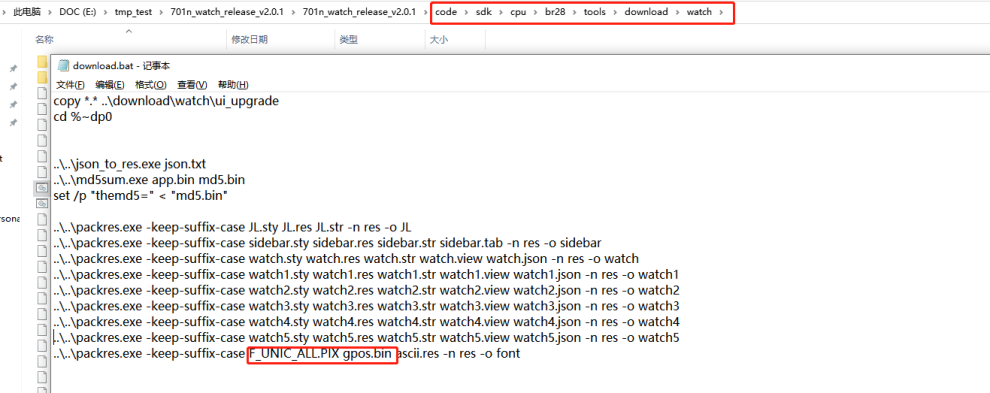
批处理中添加相关文件名,如下图所示:
在lib_system_config.c中打开unicode字库开关,如下图所示:
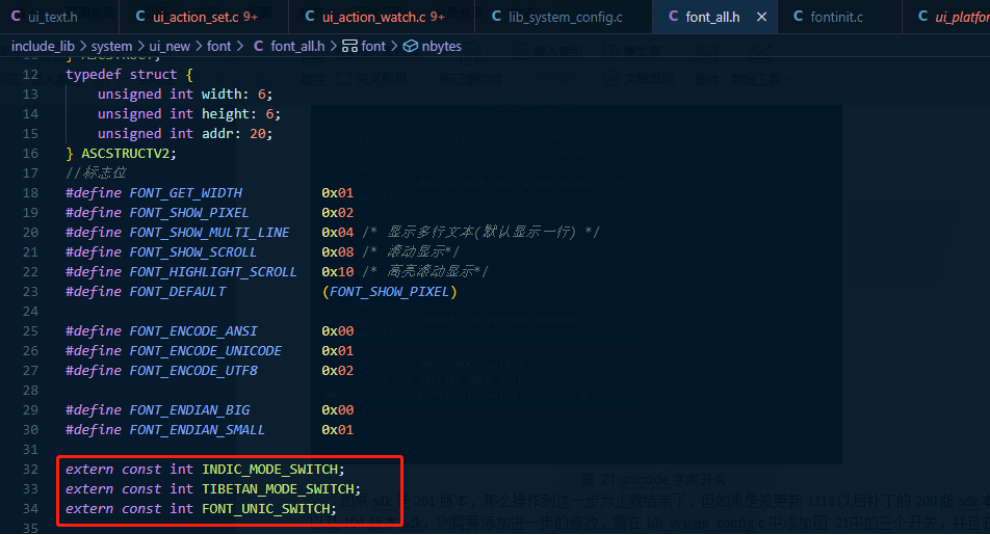
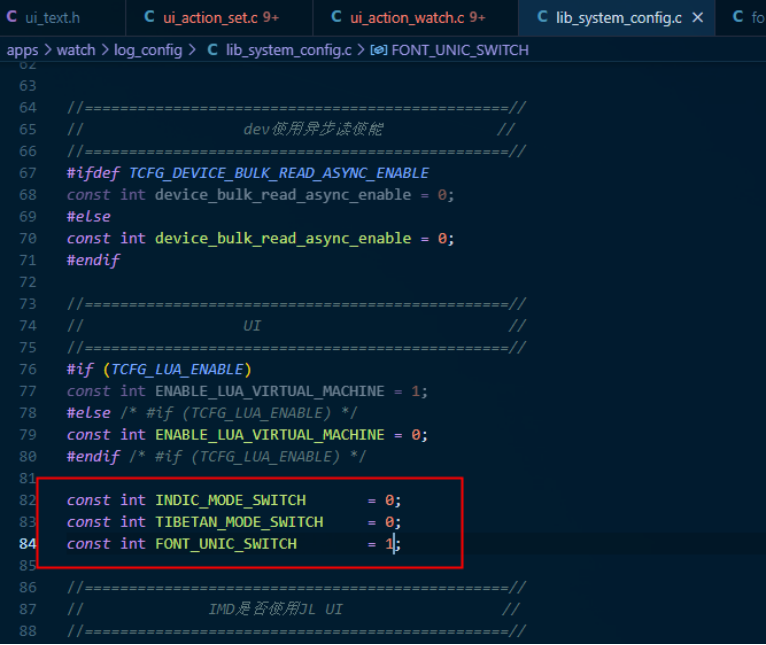 其中INDIC_MODE_SWITCH、TIBETAN_MODE_SWITCH、FONT_UNIC_SWITCH分别对应的是印地语,藏语以及unicode字库开关,结合需求进行使用。如果sdk是201版本,那么操作到这一步为止就结束了,但如果是没更新1118以后补丁的200版sdk本以及104版本sdk,则需要添加进一步的修改,需在lib_system_config.c中添加图 21中的三个开关,并且在font_all.h中改为如下图所示:
 完成以上操作后,即可正常使用unicode字库,可以直接使用第三章第四节的字库显示例程去验证是否能正常显示。
需要注意的是,unicode字库跟内码字库从应用层使用来说是一样的,unicode字库并不是只能输入unicode编码,只是与内码字库相比,不能输入内码,但带来的好处是,unicode字库支持自由裁剪代码页编码,同时后期主要维护unicode字库,故建议用户使用unicode字库。
4. 字库常用功能
(一)调整字符间距和行间距
调整字符间距的方式主要有两种,一种是设置unicode_word_space,底层会在每个字符之间加上相应的距离,但目前只有unicode字库适用,且只适用于中日韩,而对于一些特殊的语言如阿拉伯语,希伯来语,泰语,藏语和印地语等则不适用,因为加上间隔会导致原有的连写规则被破坏;另一种则是更换ttf文件,需要用户自行寻找具有一定空白边的ttf,或者尝试通过fontforge(见字模提取工具顶部的开源ttf查看工具)修改字模空白边,重新提取字模。行间距也是类似,设置unicode_line_space即可。下面讲解第一种方法的使用: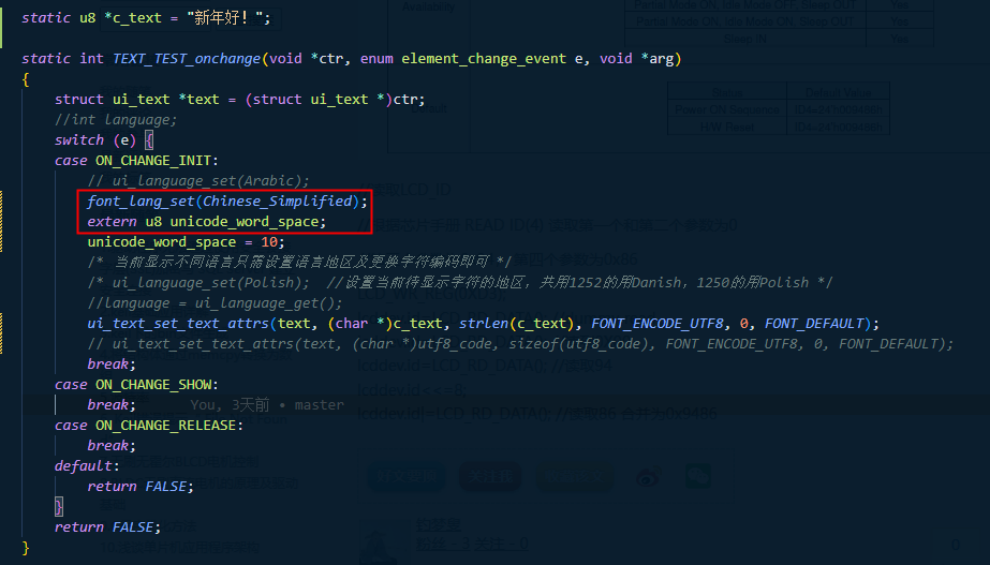
static u8 *c_text = "新年好!";

static int TEXT_TEST_onchange(void *ctr, enum element_change_event e, void *arg)
{
    struct ui_text *text = (struct ui_text *)ctr;
    //int language;
    switch (e) {
    case ON_CHANGE_INIT:
        // ui_language_set(Arabic);
        font_lang_set(Chinese_Simplified);

        /*****************修改字符间距*********************/
        extern u8 unicode_word_space;
        unicode_word_space = 10;
        /*****************修改字符间距*********************/

        /* 当前显示不同语言只需设置语言地区及更换字符编码即可 */
        /* ui_language_set(Polish);  //设置当前待显示字符的地区,共用1252的用Danish,1250的用Polish */
        //language = ui_language_get();
        ui_text_set_text_attrs(text, (char *)c_text, strlen(c_text), FONT_ENCODE_UTF8, 0, FONT_DEFAULT);
        // ui_text_set_text_attrs(text, (char *)utf8_code, sizeof(utf8_code), FONT_ENCODE_UTF8, 0, FONT_DEFAULT);
        break;
    case ON_CHANGE_SHOW:
        break;
    case ON_CHANGE_RELEASE:
        break;
    default:
        return FALSE;
    }
    return FALSE;
}
上图中设置字符间隔为10个像素,效果如下: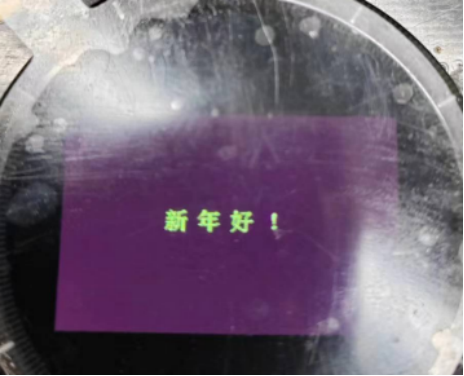
- 常见问题
(一)为什么我的多国语言表没有切换成功?
若确定ui_language_set()后再打印ui_language_get()后,多国语言id与设置进去的不一致,请检查配置界面中是否有勾选对应语言,只有勾选对应语言后才会把资源打包进去: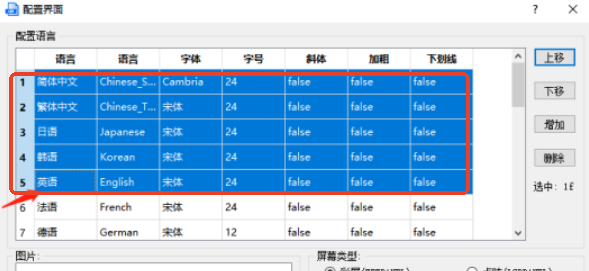 若确定ui_lanuage_set后再打印ui_language_get()后,多国语言id与设置进去的一致,但词条没切换对,请核对语言id与资源id与excel表中语言列数是否一致,具体参考第三章第二节(点击跳转)。
(二)为什么我切换阿拉伯语后显示阿拉伯语不对,是反过来的
检查是否有font_lang_set(Arabic),并打印font_lang_get(),并检查此时id是否与公版的language_list.h的一致,若不一致,建议先确认font_new.a与language_list.h的修改记录,检查因为什么原因修改到这两个文件,若是修复重大bug可联系杰理工程师同步最新字库文件,否则可自行找到相同版本的公版sdk中对应的font_new.a,font_all.h和language_list.h自行替换即可。
(三)断言font_ascii_init fail
具体原因是调用了font_ascii_init(FONT_PATH"ascii.res");但批处理没有包含ascii.res导致。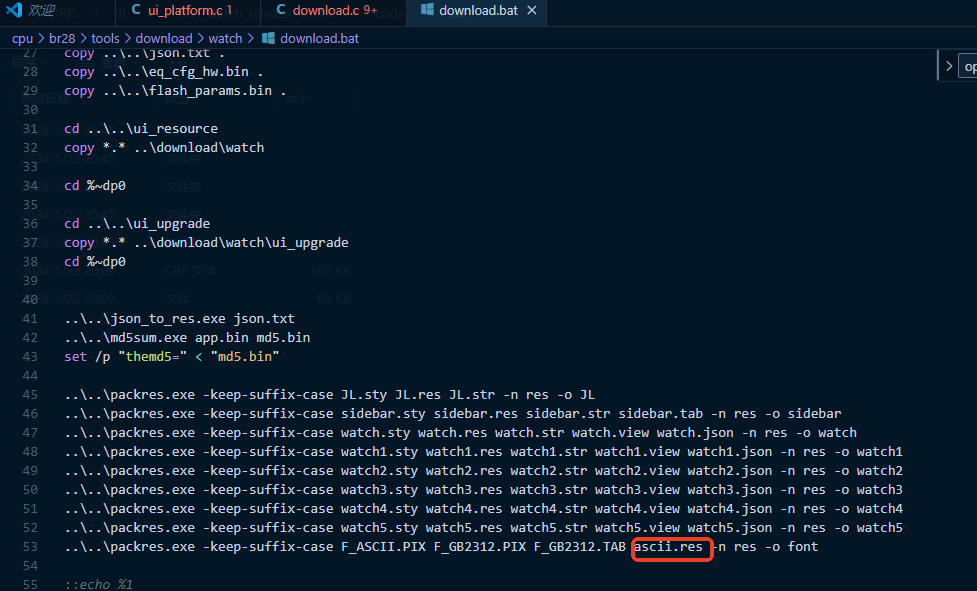 该文件用于JL UI数字控件和文字控件,图片控件和时间控件有两种方式进行显示,一种是通过图片加载数字,另一种则是使用到内置ascii字库,即ascii.res,用户可根据需求决定是否要使用ascii.res以及是否需要对其进行初始化。
(四)断言font_open fail!
常见有两种可能:
一种是font_new.a与font_all.h不配套导致,这种情况下建议与同版本sdk中对应文件进行对齐,即用同版本sdk中font_new.a和font_all.h进行替换,但不排除同期修改牵涉到其他文件,这个时候更新到最新补丁最为稳妥;
另一种可能是fontinit.c中没有配置相关id,如font_info_table中没有配置Arabic,但font_lang_set(Arabic)即会找不到id同时无法获取字库句柄,这种情况下仿照font_info_table中其他id对Arabic进行配置即可。
(五)断言can't get the width of font.或can't get the height of font.
配置的.PIX文件有问题导致,从.PIX中获取的字符宽或者高为0,可以重新生成.PIX文件进行验证,或者直接用公版的.PIX文件进行验证,在此之前建议确保当前是unicode字库。
(六)为什么印地语显示不出来
font_lang_set(Indic)后印地语完全不显示,检查fontinit.c中font_info_table的Indic id中是否配置了gpos.bin。
(七)能不能做多种不同字号的字体?
多国语言表的image和index模式支持多种字号,多国语言表的encode模式和字库暂不支持,另外多种字号也需要考虑资源大小问题。
(八)为何我的.PIX文件下载失败
检查.PIX文件名是否过长,需要满足8+3,即名称长度不超过8,后缀长度不超过3。