701 2D加速接入
📎 原始文档:https://www.kdocs.cn/l/chIn8jVCsFxC 701 2D加速接入
一、编写目的
本文档目的在于协助用户在使用第三方ui框架的情况下接入杰理2D加速模块,目前杰理IMB硬件加速支持,包括加速外挂FLASH资源合成包括图片、透明度、多国语言图片、字库文字等,下文将以LVGL 8.3.6版本的第三方开源框架接入硬件加速、使用流程以及简单的显示实验来进行讲解,用户可以基于显示实验的代码进行二次封装。
LVGL官方文档:
https://lvgl.io/
Welcome to the documentation of LVGL! — LVGL documentation
LVGL官方推荐模拟器:
https://squareline.io/
SDK 2D加速文档路径:701n_watch_release_v2.1.1\doc\固件资料\UI
二、LVGL代码移植
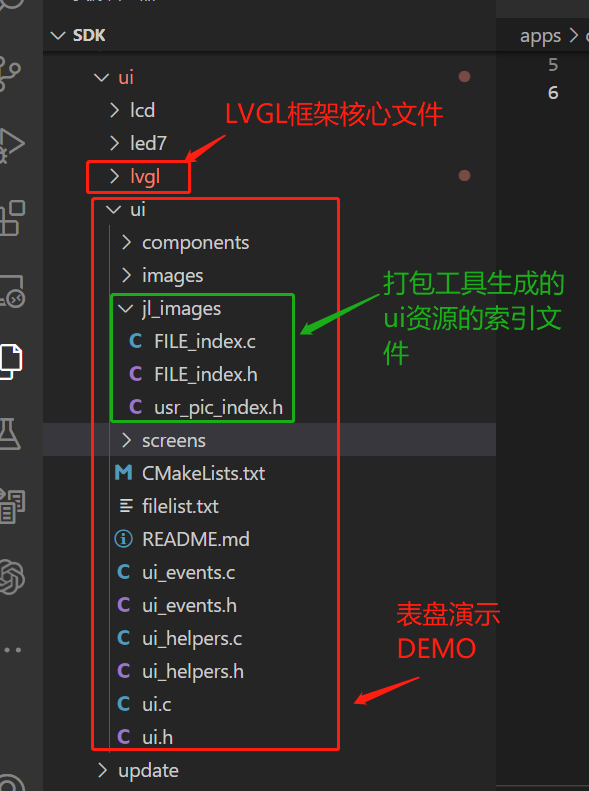
- 移植lvgl核心代码 路径.\lvgl_sdk\code\sdk\apps\common\ui
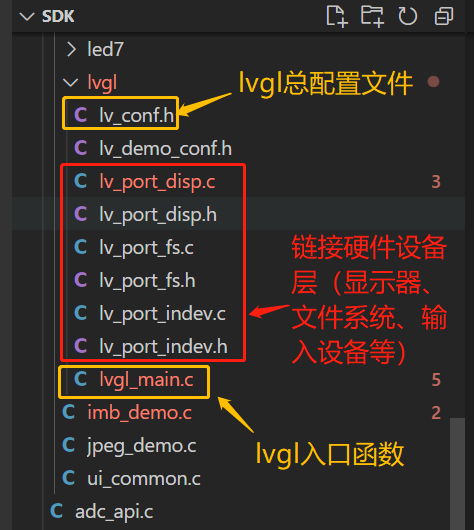
- 链接硬件层以及系统(屏幕、输入设备、文件系统) 路径.\lvgl_sdk\code\sdk\cpu\br28\ui_driver\lvgl
- lvgl:lvgl所有代码
- ui:示例演示
- port:链接硬件层(屏幕、输入设备、文件系统)
- lv_conf:配置(系统时间、内存管理映射等)
- 低功耗和亮灭屏处理。 原生LVGL任务服务函数是一直在一个while(1)循环跑,它会导致cpu无法进入低功耗,以及任务在cpu的占用率过大的问题。为解决此问题,需加入了些许处理,即增加消息挂起机制,在休眠状态时通过os_taskq_pend(挂起等消息)释放cpu进低功耗, 通过os_taskq_accept(接收消息不挂起)以及os_time_dly(延时是挂起状态)允许时释放一些时间给其它任务避免占用率过高等。通过lcd_sleep_ctrl()接口控制屏幕亮灭,亮屏时接口会自动提升cpu主频至最大值,灭屏状态会降频,并允许cpu进低功耗,具体详见穿戴手表JL701N-入门到进阶开发指导.otl”4.1 低功耗节点”。
//lvgl原生
    while (1) {
        lv_task_handler()
    }
//增加低功耗和亮灭屏处理
  static int last_time = 0;
    int time_till_next = 0; //  距离下一次执行时间,此时间与待机低功耗相关
    while (1) {
        /* 挂起并接收消息 */
        if(lcd_sleep_status()){//休眠后一直pend
            timer_stop();
            ret  = os_taskq_pend(NULL, msg, ARRAY_SIZE(msg));
            timer_start();
            lv_obj_invalidate(lv_scr_act());//触发全屏重绘
        }else{
            ret  = os_taskq_accept(ARRAY_SIZE(msg), msg);
        }

        /* 处理进出休眠的消息 */
        if (ret == OS_TASKQ) {
            if(msg[0] == UI_MSG_HIDE){
                lcd_sleep_ctrl(1);
            } else if(msg[0] == UI_MSG_SHOW){
                lcd_sleep_ctrl(0);
            }
        }

        /* 运行LVGL和休眠处理 */
        if(lcd_sleep_status())continue;
        time_till_next = lv_task_handler(); //LVGL服务函数,返回下一次执行时间
        time_till_next?os_time_dly(time_till_next/10):wdt_clear();
    }
移植到这一步,现在基本可以跑起来显示
三、IMB 2D加速使用
- 外挂资源打包管理
UI资源分组(文件系统+自定义地址管理2个DEMO,支持一键生成bin文件以及资源代码)
- 资源打包工具,使用具体参考code/UI资源分组打包/外挂flash IMB资源使用说明.txt · lazyfool/lvgl_sdk - 码云 - 开源中国 (gitee.com)
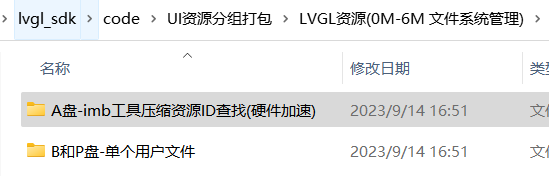
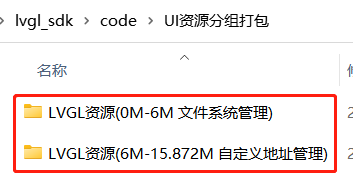 其中文件系统区分A盘\B盘\P盘资源,通过python脚本一键生成和拷贝
- 外挂资源文件系统访问
- A盘:使用IMB压缩工具压缩资源通过ID去访问(速度最快58FPS)
//  FS文件系统读取,454*454 ARGB8565测试
#include "ui/ui/jl_images/usr_pic_index.h"
#define A_SMARTWEAR_UI_BIRD_1     "123"
lv_obj_t *img_obj = lv_img_create(lv_scr_act());

lv_img_set_src(img_obj, "A:"A_SMARTWEAR_UI_BIRD_1);//58hz
lv_img_set_src(img_obj, "A:123");//58hz
- B盘:支持原生非压缩.bin图片和.jpg文件硬件加速,bin文件指的是lvgl官方Online image converter - BMP, JPG or PNG to C array or binary | LVGL所生成的文件,注意原图的宽度4字节对齐,即RGB565原图宽度需要2字节对齐,ARGB8565宽度需要4字节对齐.
//  FS文件系统读取,454*454 ARGB8565测试
lv_obj_t *img_obj = lv_img_create(lv_scr_act());

lv_img_set_src(img_obj, "B:storage/virfat_flash/C/lvimg/bird_1.bin");//55hz
/* 以及448*448 jpg图 */
lv_img_set_src(img_obj, "B:storage/virfat_flash/C/lvimg/1234.jpg");//53hz
- P盘:lvgl原生软件解码(可以用来对比2Dimb的效率)
//  FS文件系统读取,454*454 ARGB8565测试
lv_obj_t *img_obj = lv_img_create(lv_scr_act());

lv_img_set_src(img_obj, "P:storage/virfat_flash/C/lvimg/bird_1.bin");//15hz
补充:lvgl软件解码gif也可以支持,但需要申请原图4长宽的RAM
- 外挂资源自定义地址访问 具体打包工具说明参考:
code/UI资源分组打包/LVGL资源(6M-15.872M 自定义地址管理)/readme.txt · lazyfool/lvgl_sdk - 码云 - 开源中国 (gitee.com)
    //自定义,454*454 ARGB8565测试
    lv_img_dsc_t img_dst;
    open_fd("usr_nor");
    #include "ui/ui/jl_images/FILE_index.h"
    #define RES_BASE_ADDR   0x600000   //自定义区起始地址
    // lv_open_res(get_res_fd(), RES_BASE_ADDR, 0, FILE_index[FILE_bird_1], &img_dst); //54hz
    // lv_open_res(get_res_fd(), RES_BASE_ADDR, 0, FILE_index[FILE_ARGB8565_bird_1_dat], &img_dst); //58hzFILE_1199_jpg
    lv_open_res(get_res_fd(), RES_BASE_ADDR, 0, FILE_index[FILE_1234_jpg], &img_dst); //52hz
    lv_obj_t *img_obj = lv_img_create(lv_scr_act());
    lv_img_set_src(img_obj, &img_dst);
- 可以根据客户需求选择文件系统以及自定义地址的方式
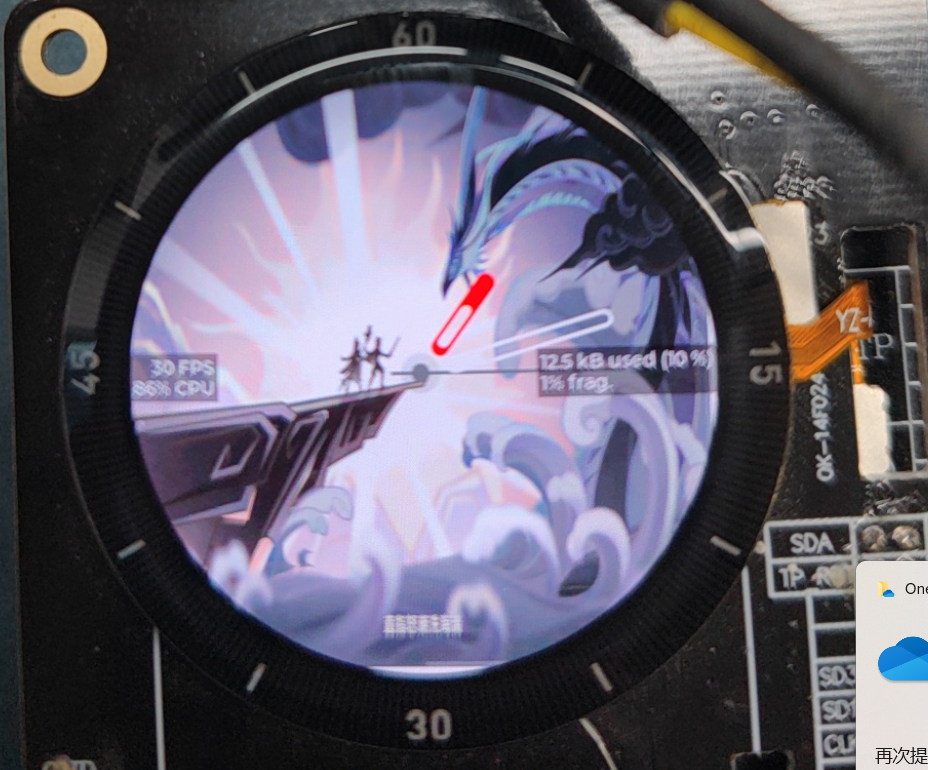
四、IMB 2D加速接入
LVGL绘图器进行第三方GPU加速:
- 获取初始信息:decoder_info()
- 布局灰度合成:dma2d_draw_ctx->blend = my_draw_blend// 纯色灰度填充MB 44fps lv 25FPS
- 压缩图片合成:dma2d_draw_ctx->base_draw.draw_img = lv_draw_jl_dma2d_img;//IMB压缩图片或jpg硬解码
- 解压图片合成:dma2d_draw_ctx->base_draw.draw_img_decoded = lv_draw_imb_img_decoded;// 对于RAM或连续的FLASH的图片非压缩图片 以下是接入流程示例
void lv_draw_jl_dma2d_ctx_init(lv_disp_drv_t * drv, lv_draw_ctx_t * draw_ctx)
{
    lv_draw_sw_init_ctx(drv, draw_ctx);

    lv_draw_sw_ctx_t * dma2d_draw_ctx = (lv_draw_sw_ctx_t *)draw_ctx;

    dma2d_draw_ctx->blend = my_draw_blend;//lv_draw_jl_dma2d_blend; //  纯色灰度填充,预先IMB合成, 其中纯色0透明度好像没啥优化效果,392*392矩形带A优化效果:IMB 44fps  lv 25FPS
    // dma2d_draw_ctx->base_draw.draw_img_decoded = lv_draw_jl_dma2d_img_decoded;//BUF图片合成
    dma2d_draw_ctx->base_draw.draw_img = lv_draw_jl_dma2d_img;//    杰理压缩图片或jpg硬解码 直接接管合成
    // // Note: currently it does not make sense use lv_gpu_jl_dma2d_wait_cb() since waiting starts right after the dma2d transfer
    // //dma2d_draw_ctx->base_draw.wait_for_finish = lv_gpu_jl_dma2d_wait_cb;
    // dma2d_draw_ctx->base_draw.buffer_copy = lv_draw_jl_dma2d_buffer_copy;

    dma2d_draw_ctx->base_draw.draw_img_decoded = lv_draw_imb_img_decoded;// 对于RAM或连续的FLASH的图片可以直接预先IMB合成
}
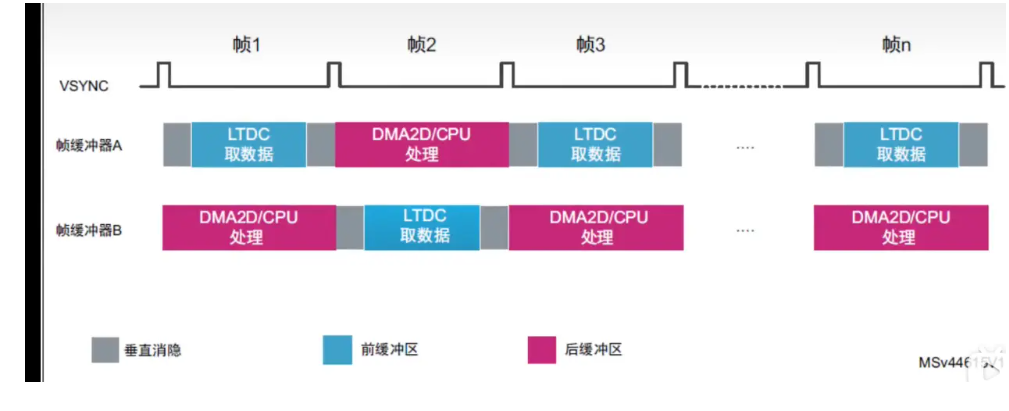
LVGL RAM分块合成原理 这个双缓冲不是LVGL显存方式里的那个双缓冲,是人为的在SDRAM里开辟另一块缓存空间,然后进行乒乓操作。LTDC显示完第一块缓存空间后,进入中断,中断里将LTDC源地址指向第二块缓存空间。
同时开启DMA2D,将LVGL刷屏数据刷入缓存空间。即LTDC在刷新第一块缓存空间时,DMA2D往第二块缓存空间快速刷入数据。LTDC在刷新第二块缓存空间时,DMA2D往第一块缓存空间快速刷入数据,如此往复。如下图所示:
作者:重回桃花源 https://www.bilibili.com/read/cv17959100/ 出处:bilibili
合成BUF分配
- 小屏用整屏一个RAM
- 大屏用双SRAM+PSRAM, 先RAM合成再DMA到PSRAM
- 使用PSRAM整帧合成(不建议):cpu合成会比较慢,大概十几帧
#if 0   //  单个整BUF(适用屏幕比较小的情况,如240*240)
        *buf1 = malloc(info.width*info.height*2);
        *buf2 = NULL;
        *lenp = info.width*info.height*2;
#elif 1 //  2个小BUFFER(屏幕比较大)
    if (__this->lcd->buffer_malloc) {
        __this->lcd->buffer_malloc(&buf, &len);
    }
    *buf2 = lcd_buffer_init(0, buf, len / info.buf_num, info.buf_num);
    *buf1 = buf;
    *lenp = len;
#else   //PSRAM整帧
    len = info.height*info.width*2;
    *lenp = len*2;
    *buf2 = malloc_psram(len);
    *buf1 = malloc_psram(len);
    psram_flush_invaild_cache(*buf2, len);
    psram_flush_invaild_cache(*buf1, len);
#endif
- IMD推屏宽需要4字节对齐,rgb565是2像素,因此需要修改rounder_cb解决局部刷新出现45度倾斜的现象
void rounder_cb(lv_disp_drv_t *disp_drv, lv_area_t *area) {
    area->x1 = (area->x1 / 2) * 2; // Round down x1 to the nearest multiple of 2
    area->x2 = (area->x2 / 2) * 2 + 1; // Round down x2 to the nearest multiple of 2
}
lv_disp_get_default()->driver->render_start_cb = render_start_cb;
- 为消除切线,可以开启TE, 屏幕产生切线原理以及消除:https://www.bilibili.com/read/cv18740493
    // 用户动态控制是否等TE信号,
    // 开PSRAM下,等TE完全消除切线,不等TE偶尔有轻微切线。
    // 不开PSRAM下,分屏刷要看绘图复杂度,等TE可能消除切线,不等TE切线比较明显
    // 等TE的帧率 = TE频率/2,帧率是固定的,如屏幕的TE是44Hz,那么实际刷新是22Hz
    // 不等TE的帧率 = 极限刷屏的帧率
    extern volatile u8 usr_wait_te;
    usr_wait_te = 0;
字库
240*296显示400个中文文字
flash->fread/memcpy->ram->显示8fps
flash->LRU(最近最少使用内存淘汰算法)->显示16fps(耗时在哈希值运算以及查找上,一秒要算20*400 = 8000次)
flash->cpu->显示0x4000000 + flash_phy_addr(读取保证4字节对齐即可,规避同时写flash) 25fps
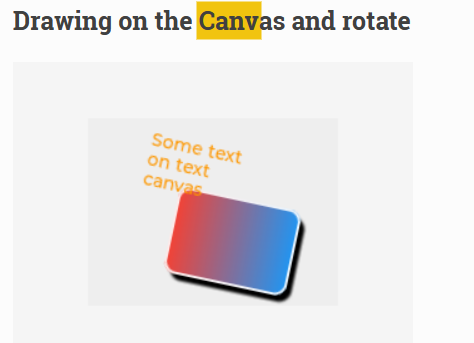
以L1格式缓存到cans画布(板块文字)454*454/8 = 26K(Byte)
存在问题
- 由于lvgl接不上imb的任务链,lvgl本身有自己的任务链管理,导致imb任务启动关闭频繁,耗时在初始化上,多张小图运算反而优势不大。(小图走软,大图走硬)
- 大屏用过RAM+PSRAM切线可以消除但帧率提不上来。
下一步改进
1.PSRAM整帧合成的优化,每一个软件合成分块RAM DMA 到PSRAM,增加imb全局任务链管理
2.整屏缩放
3.引入imb字库加速
- 移植工程链接:lvgl_sdk: lvgl_sdk,适用于杰理平台 (gitee.com)
- 建议git命令行下载,zip可能存在编码问题
- 使用vscode编译